Análisis de componentes principales: transformar datos en conocimientos veraces
Aprenderá el poder del Análisis de Componentes Principales para revelar verdades de datos ocultas.
Introducción
Análisis de componentes principales (PCA)es una técnica fundamental en estadística y ciencia de datos, que ofrece un método sofisticado para reducir la dimensionalidad de grandes conjuntos de datos, preservando al mismo tiempo la mayor variabilidad posible. Este proceso simplifica la complejidad inherente a los datos multidimensionales y mejora su interpretabilidad sin comprometer significativamente la integridad de los datos originales. En esencia, el ACP busca identificar patrones en los datos, detectar discrepancias y transformar conjuntos de datos complejos en un formato más sencillo, lo que permite a analistas y científicos descubrir información valiosa de manera más eficiente. Este artículo pretende desmitificarPCA, guiando a los lectores a través de sus fundamentos conceptuales, aplicaciones prácticas y el profundo impacto que puede tener en las estrategias análisis de los datos . Al centrarnos enPCA, buscamos orientar tanto a aficionados como a profesionales, fomentando una comprensión más profunda y el dominio de esta herramienta analítica indispensable.
Destacados
- PCA reduce las dimensiones de los datos al tiempo que preserva las características esenciales de los datos.
- Históricamente, la PCA ha evolucionado desde conceptos simples hasta aplicaciones complejas en genómica y finanzas.
- El uso correcto de PCA puede revelar patrones en los datos que inicialmente no eran evidentes.
- Elegir la cantidad correcta de componentes en PCA es crucial para una interpretación precisa de los datos.
- Las herramientas y el software de PCA agilizan el análisis y hacen que la información sobre los datos sea más accesible.
Título del anuncio
Descripción del anuncio. Lorem ipsum dolor sit amet, consectetur adipiscing elit.
La esencia del análisis de componentes principales
Análisis de componentes principales (PCA)es un procedimiento estadístico que utiliza una transformación ortogonal para convertir un conjunto de observaciones de variables posiblemente correlacionadas en valores de variables linealmente no correlacionadas, denominadas componentes principales. Esta técnica es ampliamente reconocida por su capacidad para reducir la dimensionalidad de los datos, conservando la mayor parte de la variación del conjunto de datos. La esencia del ACP radica en su capacidad para extraer la información esencial de la tabla de datos, comprimir el tamaño del conjunto de datos y simplificar su descripción, preservando al mismo tiempo las partes más valiosas de todas las variables.
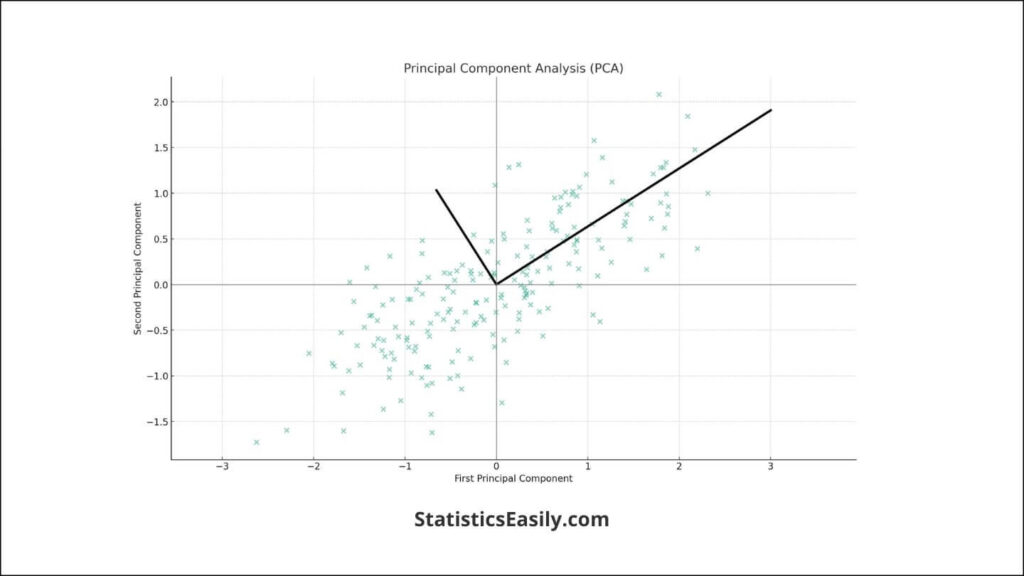
Los principios básicos del PCA implican identificar direcciones o ejes a lo largo de los cuales se maximiza la variabilidad de los datos. El primer componente principal es la dirección que maximiza la varianza de los datos. El segundo componente principal es ortogonal al primero. Identifica la dirección de la siguiente varianza más alta, y así sucesivamente. Este proceso permite a PCA reducir conjuntos de datos complejos a una dimensión inferior, lo que facilita el análisis y la visualización de los datos sin una pérdida significativa de información.
La belleza de PCA a la hora de simplificar conjuntos de datos complejos y al mismo tiempo conservar información esencial no tiene paralelo. Permite a los científicos y estadísticos de datos descubrir patrones ocultos en los datos, lo que facilita una toma de decisiones más informada. Al centrarse en los componentes más importantes, PCA ayuda a resaltar la estructura subyacente de los datos, proporcionando así una visión más clara de la verdadera naturaleza de los datos que se analizan. Este método mejora la eficiencia del análisis de datos. Contribuye a una comprensión más veraz y profunda de las propiedades intrínsecas de los datos.
Antecedentes históricos y fundamentos teóricos
El viaje deAnálisis de componentes principales (PCA)se remonta a principios del siglo XX, con el trabajo pionero de carl pearson en 1901. En su afán por comprender la estructura subyacente de los datos, Pearson desarrolló el ACP para describir la variabilidad observada en un espacio de datos multidimensional mediante variables no correlacionadas. Esta técnica fue formalizada matemáticamente por Harold Hotelling en la década de 1930, lo que proporcionó una base estadística más sólida y amplió su aplicabilidad a diversos campos científicos.
Los fundamentos matemáticos del PCA están profundamente entrelazados con el álgebra lineal, en particular los conceptos de vectores propios y valores propios. En esencia, PCA transforma los datos originales en un nuevo sistema de coordenadas donde las variaciones más significativas de cualquier proyección de datos se encuentran en las primeras coordenadas, conocidas como componentes principales. Esta transformación se logra mediante la descomposición propia de la matriz de covarianza de datos o la descomposición en valores singulares (SVD) de la matriz de datos. Estos métodos garantizan la maximización de la varianza y preservan la integridad estructural del conjunto de datos.
La precisión y veracidad del PCA residen en su rigor matemático. PCA encapsula la variabilidad inherente de los datos y las relaciones entre variables utilizando la matriz de covarianza, ofreciendo una vista resumida que destaca los patrones más significativos. Este proceso no solo simplifica la complejidad de los datos, sino que también pone en primer plano la verdad esencial (la estructura subyacente y la variabilidad de los datos), lo que permite un análisis y una toma de decisiones profundos.
PCA se ha establecido como una piedra angular del análisis de datos estadísticos a través de su desarrollo y fundamentos matemáticos. Su capacidad para reducir la dimensionalidad y al mismo tiempo preservar la información esencial lo ha convertido en una herramienta invaluable para los científicos y estadísticos de datos, ya que facilita una comprensión más profunda de los datos en numerosos campos.
Aplicaciones prácticas del análisis de componentes principales
Análisis de componentes principales (PCA)ha trascendido sus orígenes académicos para convertirse en una herramienta analítica esencial en múltiples ámbitos. Su capacidad para extraer información útil de grandes conjuntos de datos ha revolucionado la forma en que interpretamos información compleja, lo que lo hace invaluable en campos tan diversos como la genómica, las finanzas y el procesamiento de imágenes digitales.
Engenómica, el análisis de componentes principales (PCA) simplifica los datos genéticos, que a menudo involucran miles de variables. Al reducir la dimensionalidad, el PCA permite a los investigadores identificar marcadores genéticos y patrones relacionados con enfermedades de manera más eficiente, lo que facilita avances en la medicina personalizada y los estudios evolutivos.
The sector financieroutiliza el análisis de componentes principales (ACP) para la gestión de riesgos y las estrategias de inversión. El ACP permite identificar los principales factores que influyen en las variaciones del mercado mediante el análisis de la matriz de covarianza de los rendimientos de los activos. Esta simplificación facilita la diversificación de la cartera, al resaltar tendencias subyacentes que podrían pasar desapercibidas con los análisis tradicionales.
Enla compresión de imágenes, el PCA reduce la redundancia en los datos de píxeles, lo que permite el almacenamiento y la transmisión eficientes de imágenes sin una pérdida significativa de calidad. Esta aplicación es fundamental en campos donde el ancho de banda es limitado, como las imágenes satelitales y la telemedicina, y es esencial equilibrar la compresión con la preservación de la integridad de la imagen.
PCA revela patrones subyacentes en los datos a través de estas aplicaciones y simplifica significativamente los procesos de toma de decisiones. Al sintetizar conjuntos de datos complejos en sus componentes más significativos, PCA refleja la bondad inherente del análisis de datos: transforma volúmenes abrumadores de datos en conocimientos prácticos. Esta transición de la complejidad a la claridad mejora nuestra comprensión de los datos. Nos permite tomar decisiones informadas en un espectro de campos críticos, mostrando la versatilidad y relevancia duradera de PCA.
Guía paso a paso para realizar análisis de componentes principales en Python
La realización de un análisis de componentes principales (PCA) en Python condensa de manera eficiente grandes conjuntos de datos en sus componentes más importantes, lo que simplifica el análisis de datos. Esta guía recorre el proceso desde la preparación de los datos hasta la interpretación, utilizando la biblioteca scikit-learn, reconocida por sus potentes herramientas de análisis y extracción de datos.
1. Preparación de datos
Antes de implementar PCA, asegúrese de que sus datos sean adecuados para el proceso. Esto significa manejar los valores faltantes, normalizar los datos y reducir las características si están altamente correlacionadas.
import pandas as pd
from sklearn.preprocessing import StandardScaler

# Load dataset
df = pd.read_csv('data_pca.csv')

# Preprocessing
## Handle missing values if any
df.fillna(method='ffill', inplace=True)

## Feature scaling
features = ['Feature1', 'Feature2', 'Feature3', 'Feature4', 'Feature5', 'Feature6']
x = df.loc[:, features].values
x = StandardScaler().fit_transform(x)  # Normalize data
2. Implementación de PCA
Con los datos preparados, puede aplicar PCA. Decida la cantidad de componentes principales que desea conservar o deje que el algoritmo elija en función de la variación.
from sklearn.decomposition import PCA

# PCA transformation
pca = PCA(n_components=2)  # n_components to specify desired reduction
principalComponents = pca.fit_transform(x)

# Convert to a DataFrame
principalDf = pd.DataFrame(data=principalComponents, columns=['Principal Component 1', 'Principal Component 2'])
3. Análisis de los resultados
Después de transformar los datos, analice los componentes principales para comprender la estructura subyacente del conjunto de datos.
print(pca.explained_variance_ratio_)
Esto imprime la varianza explicada por cada uno de los componentes principales seleccionados, lo que da una idea de cuánta información captura el análisis.
4. Visualización
La visualización de los componentes principales puede proporcionar información intuitiva sobre la estructura y la agrupación de datos.
import matplotlib.pyplot as plt

plt.figure(figsize=(8,6))
plt.scatter(principalDf['Principal Component 1'], principalDf['Principal Component 2'])
plt.xlabel('Principal Component 1')
plt.ylabel('Principal Component 2')
plt.title('PCA on Dataset')
plt.show()
5. Interpretación
La interpretación implica comprender los componentes principales en términos de características originales. Esto a menudo requiere conocimiento del dominio y una mirada a los pesos de los componentes de PCA.
# Accessing the components_
print(abs(pca.components_))
Esto muestra el peso de cada característica original en los componentes principales, lo que ayuda a interpretar los componentes.
Resultados de conjunto de datos de ejemplo
Utilizando un conjunto de datos hipotético, el PCA podría revelar que los dos primeros componentes principales capturan una parte significativa de la varianza de los datos. La visualización puede mostrar una agrupación clara, lo que sugiere grupos distintos dentro del conjunto de datos. Los pesos de los componentes podrían indicar qué características influyen más en estos agrupamientos.
Guía paso a paso para realizar un análisis de componentes principales en R
Realizar un análisis de componentes principales (ACP) en R permite condensar de forma eficiente grandes conjuntos de datos en sus componentes más significativos, simplificando así el análisis. Esta guía describe el proceso, desde la preparación de los datos hasta su interpretación, utilizando el conjunto versátil y completo de herramientas disponibles en R para el cálculo estadístico.
1. Preparación de datos
Antes de implementar PCA, asegúrese de que sus datos sean apropiados para el proceso. Esto implica manejar los valores faltantes, estandarizar los datos y reducir las características si están altamente correlacionadas.
# Load dataset
df <- read.csv('data_pca.csv')

# Preprocessing
## Handle missing values if any
df[is.na(df)] <- method = na.omit(df)

## Feature scaling
features <- df[, c('Feature1', 'Feature2', 'Feature3', 'Feature4', 'Feature5', 'Feature6')]
scaled_features <- scale(features) # Normalize data
2. Implementación de PCA
Con los datos preparados, se puede aplicar PCA. Puede decidir la cantidad de componentes principales que desea conservar o dejar que el algoritmo elija según la variación explicada.
# PCA transformation
pca <- prcomp(scaled_features, rank. = 2, center = TRUE, scale. = TRUE)

# The rank. argument specifies the desired reduction
# prcomp automatically centers and scales the variables
3. Análisis de los resultados
Después de transformar los datos, el resumen del objeto PCA se puede utilizar para comprender la varianza explicada por los componentes principales.
# This prints the summary of the PCA object
summary(pca)
4. Visualización
La visualización de los componentes principales puede ofrecer información intuitiva sobre la estructura de datos y su posible agrupación.
# This creates a scatter plot of the first two principal components
plot(pca$x[, 1:2], col = df$YourGroupVariable, xlab = 'Principal Component 1', ylab = 'Principal Component 2', main = 'PCA on Dataset')
5. Interpretación
Interpretar PCA implica comprender cómo las características originales contribuyen a los componentes principales, lo que a menudo requiere conocimiento del dominio.
# This shows the loading of each original feature on the principal components
pca$rotation
Resultados de conjunto de datos de ejemplo
Utilizando un conjunto de datos hipotético, PCA en R podría revelar que los dos primeros componentes principales capturan una parte significativa de la varianza de los datos. La visualización puede mostrar una aparente agrupación, lo que sugiere distintos grupos dentro del conjunto de datos. Examinar la rotación (cargas) puede indicar qué características influyen más en estos agrupamientos.
Mejores prácticas y errores comunes
Adherirse a las mejores prácticas y permanecer atento a los errores comunes es crucial para interpretar datos significativos a través del análisis de componentes principales (PCA). La precisión y la verdadera representación de la esencia del conjunto de datos son esenciales.
Garantizar la precisión
- Estandarización de datos: Estandarice siempre sus datos antes de aplicar PCA, ya que el análisis es sensible a las variaciones de las variables iniciales.
- Valores faltantes: Aborde los valores faltantes o infinitos en el conjunto de datos para evitar sesgos en la extracción de componentes.
- Los valores atípicos: Investigar y comprender los valores atípicos antes de la PCA, ya que pueden influir desproporcionadamente en los resultados.
Evitar malas interpretaciones
- Interpretabilidad de los componentes: Los componentes principales son construcciones matemáticas que no siempre tienen una interpretación directa del mundo real. Tenga cuidado de no sobreinterpretarlos.
- Variaciones: Un índice de variación alto para los primeros componentes no garantiza que contengan toda la información significativa. Pueden existir sutilezas importantes en componentes con menor variación.
Elegir el número correcto de componentes
- Varianza explicada: Utilice un diagrama de pedregal o una relación de varianza explicada acumulada para identificar un punto de codo o la cantidad de componentes que capturan información sustancial.
- Parsimonia: Equilibre la complejidad con la interpretabilidad, seleccionando la menor cantidad de componentes que aún brinden una vista integral de la estructura de datos.
- Conocimiento del dominio: Aproveche la comprensión de su campo para decidir cuántos componentes retener, asegurándose de que tengan sentido para su contexto específico.
Mantenerse fiel a la esencia de los datos
- Coherencia con los objetivos: Alinear la cantidad de componentes retenidos con los objetivos analíticos, ya sea la simplificación de datos, la reducción de ruido o el descubrimiento de estructuras latentes.
- Revisión completa: Combine PCA con otras técnicas de exploración de datos para desarrollar una comprensión holística de los datos.
Seguir estas pautas guiará a su PCA hacia un análisis confiable, preservando la integridad de los datos y extrayendo información útil. Si se es cauteloso con las complejidades involucradas en el PCA, se pueden evitar los errores que conducen a interpretaciones erróneas y garantizar que el análisis siga siendo un reflejo auténtico del conjunto de datos subyacente.
Temas avanzados en análisis de componentes principales
A medida que el panorama de los datos continúa expandiéndose y diversificándose, el Análisis de Componentes Principales (PCA) evoluciona, adoptando sus raíces clásicas y expansiones innovadoras para abordar la complejidad de las estructuras de datos modernas. Este viaje a los temas avanzados de PCA revela la versatilidad del método y su adaptabilidad duradera en la ciencia de datos.
Variaciones de PCA
- PCA del núcleo: Esta extensión de PCA se utiliza para la reducción de dimensionalidad no lineal. El uso de métodos de kernel captura efectivamente la estructura de los datos donde la relación entre variables no es lineal, descubriendo así patrones que el PCA tradicional podría pasar por alto.
- PCA escaso: En conjuntos de datos donde las características superan en número a las observaciones, Sparse PCA brilla al producir componentes principales con cargas escasas. Esto da como resultado un modelo más interpretable, que destaca un subconjunto más pequeño de características, lo que es particularmente útil en escenarios de datos de alta dimensión como la genómica.
Extensiones de PCA
- PCA incremental: Para conjuntos de datos masivos que no caben en la memoria, Incremental PCA ofrece una solución. Divide el cálculo de PCA en minilotes manejables, actualizando los componentes de forma incremental, lo que también resulta ventajoso para la transmisión de datos.
- PCA robusto: Los valores atípicos pueden afectar significativamente el resultado de la PCA. Una PCA sólida mitiga esto al separar los escasos valores atípicos de la estructura de rango bajo, asegurando que los puntos anómalos no distorsionen los datos centrales.
Título del anuncio
Descripción del anuncio. Lorem ipsum dolor sit amet, consectetur adipiscing elit.
Conclusión
El Análisis de Componentes Principales (PCA) se ha establecido firmemente como una técnica indispensable en la caja de herramientas de análisis de datos. Facilita una comprensión más profunda de los datos extrayendo sus elementos más informativos. Esta guía ha buscado aclarar la metodología de PCA, desde sus matemáticas fundamentales hasta su aplicación en diversos campos. Hemos subrayado su utilidad para reducir la dimensionalidad y al mismo tiempo preservar la estructura inherente de los datos. Este proceso ayuda significativamente tanto en la visualización como en los análisis posteriores. Se anima a los investigadores y científicos de datos a integrar PCA en sus flujos de trabajo para mejorar la interpretabilidad de conjuntos de datos complejos. Cuando se implementa cuidadosamente, PCA proporciona información sobre los patrones dominantes dentro de los datos y agiliza el camino hacia una toma de decisiones más sólida e informada.
Artículos recomendados
Explore la rica biblioteca de artículos de nuestro blog sobre temas relacionados para descubrir más sobre el análisis de datos.
- Técnica de Richard Feynman: un camino para aprender cualquier cosa en análisis de datos
- Comprensión de las distribuciones de modelos lineales generalizados
- ¿Pueden las desviaciones estándar ser negativas? (Historia)
- Diagrama de caja: una poderosa herramienta de visualización de datos
- Modelos lineales generalizados (Historia)
Preguntas Frecuentes (FAQ)
PCA es un procedimiento cuantitativo diseñado para enfatizar la variación y extraer patrones significativos de un conjunto de datos, identificando efectivamente los principales ejes de variabilidad.
PCA desempeña un papel fundamental en la simplificación de conjuntos de datos de alta dimensión al retener tendencias y patrones centrales, mejorando así la interpretabilidad sin una pérdida significativa de información.
PCA opera calculando los componentes principales que maximizan la varianza dentro del conjunto de datos, transformando los datos en un nuevo sistema de coordenadas con estos ejes principales.
De hecho, PCA es una herramienta valiosa para modelos predictivos, ya que reduce la dimensionalidad, mejorando así el rendimiento del modelo al filtrar el ruido y la información menos relevante.
PCA se utiliza ampliamente en diversos dominios analíticos, incluidas las finanzas, la bioestadística y las ciencias sociales, donde ayuda a analizar y comprender datos complejos.
La elección de los componentes del PCA debe alinearse con la cantidad de varianza explicada, generalmente evaluada mediante gráficos de pedregal o varianza acumulativa, y equilibrada con la interpretabilidad de los datos.
PCA podría ser menos efectivo con conjuntos de datos donde las relaciones entre variables no son lineales y sensibles al escalamiento de datos.
PCA es óptimo para datos numéricos continuos. Se necesitan pasos de preprocesamiento específicos para que los datos categóricos garanticen la aplicación precisa de las técnicas de PCA.
PCA ayuda en la anonimización de los datos al transformar las variables originales en componentes principales, lo que complica la identificación directa de los registros individuales.
Las bibliotecas para PCA están disponibles en entornos de software como R y Python, especialmente en paquetes como scikit-learn, que proporcionan herramientas integrales para la ejecución de PCA.