Exactitud, precisión, recuperación o F1: ¿qué métrica prevalece?
Aprenderá las diferencias cruciales entre exactitud, precisión, recuperación y F1 para elegir la métrica de evaluación correcta.
Introducción
EnCiencia de los datosymodelado predictivo, medir con precisión el rendimiento de un modelo es tan crucial como desarrollar el modelo en sí. Sin embargo, en medio de un mar de métricas —exactitud, precisión, exhaustividad y puntuación F1—, elegir la que mejor se ajuste al objetivo del análisis sigue siendo un desafío complejo.
Quizás se pregunte: "¿Qué métrica se adapta mejor a la verdad del poder predictivo de mi modelo?" Esta decisión tiene profundas implicaciones, no sólo para la integridad de su modelo sino también para las consecuencias en el mundo real que dependen de sus predicciones.
Consideremos el sector sanitario, donde la capacidad de un modelo para predecir enfermedades puede ser cuestión de vida o muerte. En este ámbito, la elección de la métrica trasciende la mera cantidad de datos: se convierte en un testimonio del valor que otorgamos a la vida y el bienestar humanos. En este contexto, ¿ basta conprecisiónpor sí sola cuando se pasa por alto un falso negativo, un paciente diagnosticado erróneamente como libre de enfermedad?
Consideremos, por ejemplo, el ámbito de la detección de fraudes financieros. ¿De qué sirve un modeloprecisasi no detecta las transacciones fraudulentas, confundiéndolas con actividades legítimas? Las repercusiones no se limitan a pérdidas monetarias, sino que socavan la confianza que sustenta el sistema financiero.
En las siguientes secciones, analizaremos cada métrica con precisión, desentrañaremos los contextos donde cada métrica brilla y, en última instancia, lo equiparemos con el discernimiento para seleccionar una métrica que refleje la eficacia de su modelo y resuene con los imperativos éticos de su trabajo.
Destacados
- La precisión puede ser engañosa; una puntuación del 99.9 % podría ignorar importantes falsos negativos.
- La precisión mide cuántos positivos previstos son verdaderos, lo cual es esencial en la detección de spam.
- Recall calcula la tasa de captura de positivos reales, lo cual es vital en la detección de fraudes y enfermedades.
- La puntuación F1 equilibra la precisión y la recuperación, lo que resulta útil en distribuciones de clases desiguales.
- La elección de métricas depende del contexto; ninguna métrica se adapta a todas las situaciones.
Título del anuncio
Descripción del anuncio. Lorem ipsum dolor sit amet, consectetur adipiscing elit.
Los peligros de confiar únicamente en la precisión
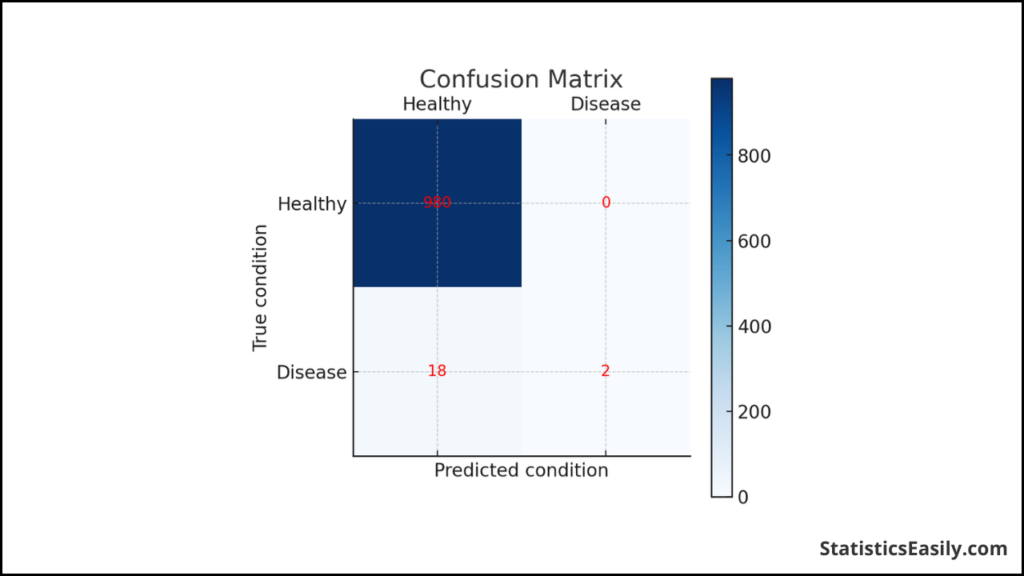
Exactitudsuele considerarse la medida esencial del rendimiento de un modelo, una prueba evidente de su capacidad predictiva. Pero, ¿lo dice todo? Analicemos lamatriz de confusión, una representación gráfica de los valores reales frente a los predichos, para descubrir la verdad que se esconde tras las cifras.
Aquí hay una matriz de confusión hipotética para un modelo de predicción de enfermedades:
| Condición verdadera | Predicho saludable | Enfermedad prevista |
|---|---|---|
| Sanos | 980 | 0 |
| Enfermedades | 18 | 2 |
| Negativo previsto | Positivo previsto | |
|---|---|---|
| Negativo real | Verdadero negativo | falso positivo |
| Positivo real | Falso negativo | Verdadero Positivo |
A primera vista, unaprecisióndel 98.2 % podría parecer encomiable. Sin embargo, este único indicador oculta una grave realidad. De 20 casos reales de la enfermedad, el modelo no logró identificar 18. Estosfalsos negativosconllevan un alto costo de clasificación errónea: si no se detectan ni se tratan, su estado podría empeorar o podrían propagar la enfermedad sin saberlo.
Imagínese las implicaciones en un escenario real: un brote de una enfermedad contagiosa donde la detección temprana es fundamental. Un modelo con tal índice de precisión podría provocar un desastre de salud pública. En este caso, la métricaprecisiónno solo es engañosa, sino que además es potencialmente peligrosa.
Exactitudnos genera una falsa sensación de seguridad, ocultando fallos críticos que pueden tener consecuencias nefastas. La precisión por sí sola es insuficiente en contextos donde el coste de unfalso negativoes elevado, como en la sanidad o la ciberseguridad. Debemos ir más allá de las métricas que consideran el peso de cada clasificación errónea para orientarnos hacia un modelo que no solo prediga, sino que también proteja.
Precisión: el arte de ser específico
Precisiónse revela como una métrica crucial para evaluar el rendimiento de un modelo, especialmente en escenarios donde el costo de un falso positivo es elevado. La precisión es la proporción de verdaderos positivos con respecto al total de positivos predichos; mide la exactitud de un modelo al identificar únicamente las instancias relevantes.
Consideremos un sistema de detección de spam: un correo electrónico marcado erróneamente como spam (falso positivo) puede media perder una comunicación crucial. En este caso, la precisión es fundamental para evitar errores tan costosos. No se trata solo de detectar todo el spam, sino de garantizar que los correos electrónicos legítimos no se pierdan.
La fórmula paraprecisiónes una expresión simple pero profunda:
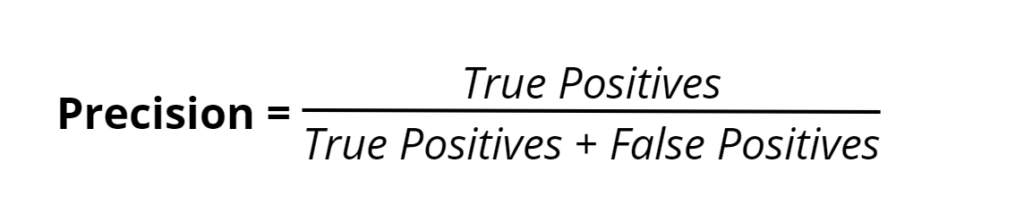
Esto se traduce en la proporción de aspectos positivos reales de todos los casos que el modelo calificó como positivos. En nuestro ejemplo anterior de atención sanitaria, un modelo de alta precisión identificaría correctamente a los pacientes con la enfermedad y minimizaría los diagnosticados erróneamente, manteniendo la confianza en el proceso de diagnóstico médico.
Hay mucho en juego en campos como las finanzas, donde un falso positivo podría significar que una transacción legítima sea marcada como fraudulenta. La precisión garantiza que las transacciones cotidianas no se vean obstruidas, lo que refleja la capacidad del modelo para mantener la integridad operativa y la responsabilidad ética hacia las partes interesadas.
Así, mientras queprecisiónnos ofrece una visión general del rendimiento de un modelo,precisiónse centra en los detalles, prestando especial atención a la calidad de las predicciones positivas. Es una prueba de la capacidad del modelo no solo para detectar, sino también para discernir, lo que refleja el compromiso con la verdad y la fiabilidad que se exigen en la toma de decisiones de alto riesgo.
Retirada del mercado: garantizar una detección integral
Recordarsirve como indicador clave para la detección integral en el panorama de las métricas de rendimiento. Esta métrica no solo evalúa si nuestras predicciones son correctas, sino también si estamos capturando todos los casos de verdaderos positivos. La exhaustividad se define como la fracción del total de instancias relevantes que se recuperaron realmente.
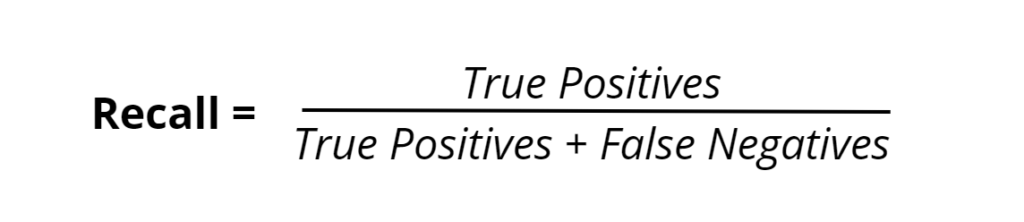
En la atención sanitaria, no se puede subestimar el papel del recuerdo. Para afecciones como el cáncer, no identificar un caso positivo (un falso negativo) podría significar una oportunidad perdida para una intervención temprana, lo que puede afectar significativamente las tasas de supervivencia de los pacientes. En este caso, una alta tasa de recuperación garantiza que se identifiquen casi todos los casos de enfermedades, lo cual es imperativo.
De manera similar, en la detección de fraudes, el costo de no detectar una transacción fraudulenta es sustancial. Si bien un falso positivo en este contexto puede llevar a la insatisfacción del cliente, un falso negativo podría significar pérdidas financieras significativas y daños a la credibilidad institucional. Por lo tanto, un modelo que se incline hacia una mayor recuperación podría ser preferible en tales campos, incluso si corre el riesgo de algunos falsos positivos más.
El imperativo de retirada se extiende más allá de la precisión técnica; se hace eco de la responsabilidad moral de minimizar el daño. En campos donde el costo de pasar por alto un positivo es mucho mayor que el costo de identificar uno incorrectamente, el recuerdo se convierte en la métrica de la elección ética. Se trata de garantizar que un sistema incluya lo más posible todos los casos reales y encarne el compromiso de hacer el bien mediante una detección exhaustiva.
La puntuación de F1: equilibrio entre precisión y recuperación
The F1 Scoresirve como un equilibrio armónico entre precisión y exhaustividad, proporcionando una métrica única que engloba ambas dimensiones de la exactitud de un modelo. Resulta beneficiosa en escenarios donde es fundamental dar igual peso a los falsos positivos y a los falsos negativos. La puntuación F1 se define como la media armónica de la precisión y la exhaustividad.
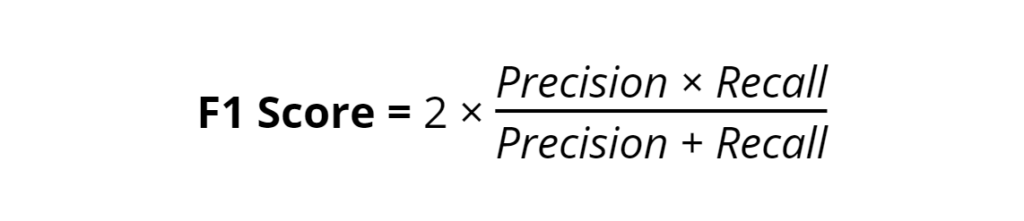
Esta fórmula garantiza que la precisión y la recuperación contribuyan por igual a la puntuación, penalizando los valores extremos en los que cualquiera de las métricas es demasiado baja. El F1 Score destaca por su uso sobre la precisión, especialmente en conjuntos de datos desequilibrados donde una clase supera significativamente a otra. En tales casos, la precisión por sí sola podría sugerir un desempeño engañosamente alto simplemente prediciendo la clase mayoritaria.
Consideremos un conjunto de datos con un grave desequilibrio de clases, como transacciones fraudulentas en un gran conjunto de datos de actividades financieras. Un modelo puede ser muy preciso al predecir raramente el fraude, pero pasar por alto la mayoría de las transacciones fraudulentas debido a su rareza. En este caso, una puntuación F1 alta indicaría no solo que el modelo captura la mayoría de los casos de fraude (recuperación alta), sino también que no marca excesivamente transacciones legítimas como fraude (alta precisión).
En esencia, la puntuación F1 trasciende la simplicidad de la exactitud al incorporar la profundidad de la precisión y la amplitud de la recuperación, guiándonos así hacia una evaluación más equilibrada y matizada del rendimiento del modelo. Requiere un modelo que no sólo identifique o excluya, sino que haga ambas cosas juiciosamente en busca de una representación más veraz de la realidad en nuestras decisiones basadas en datos.
Análisis comparativo de todas las métricas
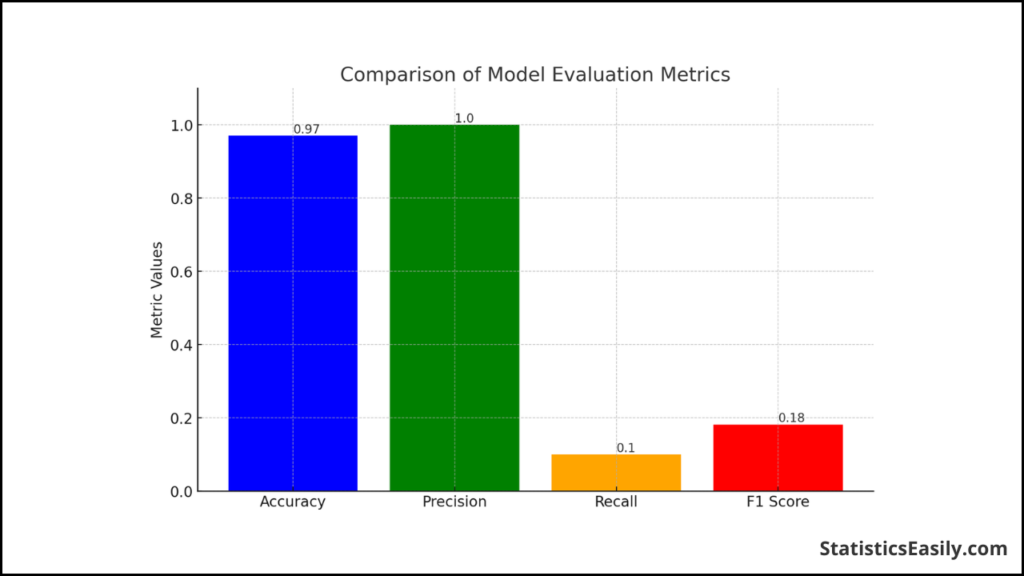
En el ámbito analítico, la esencia de la evaluación de un modelo suele resumirse en cuatro métricas clave:exactitud, precisión, exhaustividady laF1 Score. Cada una de estas métricas ofrece una perspectiva única sobre el rendimiento del modelo, y comprender su interacción es fundamental para seleccionar la más adecuada según el problema empresarial específico en cuestión.
El siguiente gráfico de barras ilustra las diferencias entre estas cuatro métricas basándose en un modelo hipotético de predicción de enfermedades:
| Condición verdadera | Predicho saludable | Enfermedad prevista |
|---|---|---|
| Sanos | 980 | 0 |
| Enfermedades | 18 | 2 |
A continuación se muestra un desglose del rendimiento del modelo en diferentes métricas:
- Exactitud: 97%: aunque es alto, no tiene en cuenta la gravedad de los falsos negativos de nuestro conjunto de datos.
- Precisión: 100%: todas las predicciones positivas del modelo son correctas, pero esto no considera la cantidad de verdaderos positivos omitidos.
- Recordar: 10%: esta puntuación baja indica que el modelo no logra identificar el 90% de los casos positivos reales, un defecto crítico en contextos específicos como el diagnóstico de enfermedades.
- F1 Score: Aproximadamente 0.18: esta puntuación equilibra la precisión y la recuperación, pero en este caso, se inclina hacia la precisión debido a la muy baja recuperación.
Al elegir una métrica, se deben considerar las implicaciones comerciales de los falsos positivos y falsos negativos. En escenarios como el de la atención sanitaria, un alto número de retiros es esencial para garantizar que se identifiquen todos los casos de enfermedades a pesar del riesgo de falsos positivos. Por el contrario, la precisión puede ser más importante en escenarios como la detección de spam, donde los falsos positivos (correos electrónicos legítimos marcados como spam) pueden ser muy perjudiciales.
The F1 Scoreresulta especialmente útil cuando se necesita una única medida para equilibrar la precisión y la exhaustividad. Es particularmente relevante en conjuntos de datos desequilibrados, donde la sobrerrepresentación de una clase podría distorsionar la precisión.
En resumen, si bien la precisión proporciona una idea general del rendimiento del modelo, la precisión, la recuperación y la puntuación F1 ofrecen una visión más matizada que se puede adaptar a las necesidades específicas de un problema. El despliegue de un modelo debe guiarse por una métrica que se alinee con el objetivo final: salvaguardar la salud humana o proteger los activos financieros, adoptando así tanto el rigor científico como los imperativos éticos de las aplicaciones del mundo real.
Conclusión
A medida que profundizamos en las complejidades de las métricas de evaluación de modelos, se hace evidente la importancia de comprender los atributos y aplicaciones únicos de cada métrica.La exactitud, la precisión, la exhaustividady lapuntuación F1revelan diferentes aspectos del rendimiento de un modelo, ofreciendo información valiosa para perfeccionar nuestras herramientas predictivas.
Exactitudofrece una visión general amplia, pero no siempre refleja la dinámica sutil del rendimiento del modelo, especialmente en presencia de desequilibrios de clases.Precisiónresalta la capacidad del modelo para minimizar los falsos positivos, lo cual es crucial cuando el costo de etiquetar erróneamente una instancia es alto. Por otro lado,recall garantiza que el modelo capture la mayor cantidad posible de verdaderos positivos, una preocupación vital en campos como la atención médica y la detección de fraude, donde no detectar una instancia positiva podría tener consecuencias nefastas. Lapuntuación F1armoniza la exactitud y la exhaustividad, proporcionando una métrica equilibrada particularmente útil en situaciones donde los falsos positivos y los falsos negativos tienen un peso significativo.
La “mejor” selección de métricas depende inherentemente del contexto, subrayada por las demandas e implicaciones específicas del problema en cuestión. Por ejemplo, la retirada podría tener prioridad en un escenario de diagnóstico médico para garantizar que ninguna condición pase desapercibida. Por el contrario, la precisión podría ser más crítica en la detección de spam en el correo electrónico para evitar clasificar erróneamente los mensajes esenciales.
En conclusión, es primordial adoptar un enfoque reflexivo y perspicaz para la selección de métricas. Requiere una alineación con los imperativos éticos y las realidades prácticas de cada aplicación, asegurando que nuestros modelos no solo predigan con precisión sino que lo hagan de una manera que defienda los valores de la verdad. Este compromiso con la ciencia de datos basada en principios nos permite aprovechar todo el potencial de nuestros modelos, impulsando innovaciones que no solo son técnicamente competentes sino también éticamente sólidas y contextualmente relevantes.
Título del anuncio
Descripción del anuncio. Lorem ipsum dolor sit amet, consectetur adipiscing elit.
Artículos recomendados
Profundice en la precisión de los datos y la evaluación de modelos: descubra más artículos sobre estos temas esenciales en nuestro blog.
- Diez técnicas revolucionarias para dominar el análisis de datos
- 5 estudios de casos de estadística que te dejarán boquiabierto
- Cómo las estadísticas pueden cambiar tu vida: una guía para principiantes
Preguntas Frecuentes (FAQ)
P1: ¿Qué es la precisión en la evaluación de modelos?La precisión es la proporción de resultados verdaderos (tanto verdaderos positivos como verdaderos negativos) entre el número total de casos examinados.
P2: ¿Por qué es necesaria la precisión en los modelos predictivos?La precisión es crucial cuando el costo de un falso positivo es alto, como en la detección de spam, donde se podrían filtrar incorrectamente correos electrónicos válidos.
P3: ¿Cuándo es la precisión la métrica preferida?La precisión debe priorizarse en situaciones donde no detectar un resultado positivo real es perjudicial, como en el diagnóstico de enfermedades graves.
P4: ¿Cómo ayuda la puntuación F1 en la evaluación del modelo?La puntuación F1 equilibra la precisión y la exhaustividad, lo cual es particularmente beneficioso al trabajar con conjuntos de datos desequilibrados.
P5: ¿Puede un modelo con alta precisión tener fallos?Sí, un modelo puede tener alta precisión pero aun así no lograr identificar los casos positivos, lo que lo hace ineficaz en aplicaciones específicas.
P6: ¿Es mejor tener mayor precisión o mayor exhaustividad?La preferencia por una mayor precisión o exhaustividad depende de la aplicación específica y de las consecuencias de los falsos positivos o negativos.
P7: ¿Cuál es la diferencia entre exactitud y precisión?La exactitud se refiere a la proximidad de las mediciones a un valor específico. En cambio, la precisión se refiere a la proximidad de las mediciones entre sí.
P8: ¿Puede la puntuación F1 ser equivalente a la precisión?La puntuación F1 a veces puede ser similar a la precisión. Sin embargo, son métricas distintas y pueden diferir según el equilibrio del conjunto de datos.
P9: ¿Cómo se calcula la puntuación F1?La puntuación F1 es la media armónica de la precisión y la exhaustividad, calculada como 2 * (precisión * exhaustividad) / (precisión + exhaustividad).
P10: ¿Por qué la precisión podría no ser la mejor métrica para un modelo de clasificación?La precisión podría no ser la mejor opción para conjuntos de datos sesgados, donde una clase supera significativamente a la otra, ya que la clase mayoritaria puede influir en los resultados.