Guía de selección de funciones de enlace y distribución del modelo lineal generalizado (GLM)
Aprenderá a seleccionar la función de enlace y distribución del modelo lineal generalizado para obtener una precisión de modelado óptima.
Introducción
Los modelos lineales generalizados (GLM) representan una extensión de los modelos de regresión lineal tradicionales diseñados para adaptarse a una amplia gama de tipos de datos y patrones de distribución. Esta flexibilidad hace que los GLM sean indispensables en el arsenal de científicos y estadísticos de datos. En esencia, los GLM constan de tres componentes principales:
- The componente aleatorio especifica la distribución de probabilidad de la variable de respuesta;
- The componente sistemático relaciona los predictores con la respuesta a través de una función predictora lineal;
- The función de enlace conecta la media de la distribución con el predictor lineal.
Seleccionar unaFunción de enlace y distribución del modelo lineal generalizadono es solo una decisión técnica; es un arte que mejora la precisión y el rendimiento predictivo del modelo. Comprender cómo adaptar la distribución y la función de enlace a las características inherentes de los datos es fundamental para aprovechar al máximo el potencial de los modelos lineales generalizados (GLM), lo que permite realizar análisis más perspicaces y fiables. Esta guía tiene como objetivo mostrar el camino hacia la configuración óptima del modelo, asegurando que su GLM capture la verdadera esencia de sus datos.
Destacados
- Elegir la distribución GLM correcta mejora significativamente la precisión del modelo.
- Las funciones de enlace transforman las predicciones del modelo a la escala de la variable de respuesta.
- La distribución binomial con un enlace logit es ideal para datos de resultados binarios.
- El ajuste del modelo mejora al hacer coincidir la distribución con la naturaleza de los datos.
- Las funciones de enlace de prueba iterativas pueden revelar el mejor rendimiento del modelo.
Título del anuncio
Descripción del anuncio. Lorem ipsum dolor sit amet, consectetur adipiscing elit.
Comprender la distribución GLM
Los modelos lineales generalizados (MLG) son fundamentales en el análisis estadístico, ya que se adaptan a una amplia gama de tipos de datos gracias a su estructura flexible. Su utilidad se basa en el concepto deDistribución GLM, que permite a estos modelos superar las limitaciones de la regresión lineal tradicional al incorporar distribuciones más allá de la normal. Esta sección profundiza en las diversas distribuciones que sustentan los MLG y le guiará para alinear sus datos con laDistribución GLM.
Distribuciones diversas para tipos de datos variados
Los GLM están diseñados exclusivamente para manejar diferentes distribuciones de datos, cada una de las cuales atiende a tipos específicos de variables de respuesta. La distribución binomial se emplea con frecuencia para resultados binarios, como escenarios de éxito/fracaso. Por el contrario, la distribución de Poisson es fundamental para contar datos y abordar "¿cuántos?". Para datos continuos que se adhieren a valores positivos, la distribución Gamma ofrece un modelo adecuado. Cada distribución está diseñada para capturar la esencia de la estructura de datos subyacente, asegurando que los supuestos del modelo se alineen con el comportamiento natural de los datos.
Adaptando el modelo a sus datos
Seleccionar laDistribución GLMadecuada no es un proceso universal, sino una decisión compleja que influye significativamente en la precisión e interpretabilidad del modelo. La clave reside en comprender la distribución de los datos y sus características inherentes. Por ejemplo, la distribución de Poisson podría ser un buen punto de partida si los datos representan recuentos o tasas. Por el contrario, la distribución binomial podría ser más apropiada para datos binarios o de proporción. Este proceso de selección es fundamental, ya que garantiza que el GLM refleje los procesos reales que generan los datos, mejorando así la capacidad predictiva y la interpretabilidad del modelo.
Al relacionar cuidadosamente sus datos con laDistribución GLMadecuada , usted eleva el rigor analítico de su estudio, allanando el camino hacia información más precisa y significativa. Este paso fundamental es esencial para aprovechar todo el potencial de los GLM, permitiéndoles articular las complejas historias ocultas en sus datos.
El papel de las funciones de enlace en los GLM
Las funciones de enlace son los ejes de los modelos lineales generalizados (GLM) y sirven como puente crítico entre los predictores lineales y el valor esperado de la variable de respuesta. No se puede subestimar su función, ya que permiten modelar una amplia gama de tipos de datos más allá de las capacidades de la regresión lineal tradicional. Al transformar las predicciones a la escala de la variable de respuesta, las funciones de enlace garantizan que los resultados del modelo se adhieran al rango y la distribución de datos apropiados, mejorando así la interpretabilidad y precisión de las predicciones del modelo.
Transformar las predicciones en realidad: la esencia de las funciones de enlace
Las funciones de enlace no son universales; se seleccionan cuidadosamente en función de la naturaleza de la variable de respuesta y la distribución elegida para el modelo lineal generalizado (GLM). Las funciones de enlace estándar incluyen la funciónlogit, ampliamente utilizada en la regresión logística para datos binarios, que transforma las probabilidades en una escala continua ilimitada. La función de enlaceidentidad, inherente a los modelos de distribución normal, presupone una relación directa entre las variables predictoras y la variable de respuesta. La función de enlace logarítmica es típica para datos de conteo modelados con una distribución de Poisson, lo que garantiza que las predicciones del modelo permanezcan positivas y continuas.
Aplicaciones de funciones de enlace: de la teoría a la práctica
La elección de la función de enlace tiene profundas implicaciones para la aplicación e interpretación del modelo. Por ejemplo, en epidemiología, el vínculo logit en la regresión logística modela las probabilidades de que ocurra un evento, como la presencia o ausencia de una enfermedad. En economía, el vínculo de identidad en los modelos de regresión lineal predice directamente resultados cuantitativos como los ingresos basándose en predictores como la educación y la experiencia. Mientras tanto, en los seguros, el vínculo exponencial en los modelos de regresión de Poisson cuenta, lo que garantiza que las predicciones no sean negativas y sean discretas.
Al seleccionar y aplicar hábilmente la función de enlace adecuada, los estadísticos y científicos de datos pueden crear GLM que capturen los patrones subyacentes en sus datos y transmitan sus hallazgos de una manera precisa e intuitivamente comprensible a su audiencia. Esta sección de la guía desmitifica la selección y aplicación de funciones de enlace, proporcionándole el conocimiento para mejorar la precisión y la interpretabilidad de sus GLM.
Seleccionar la distribución y la función de enlace adecuadas
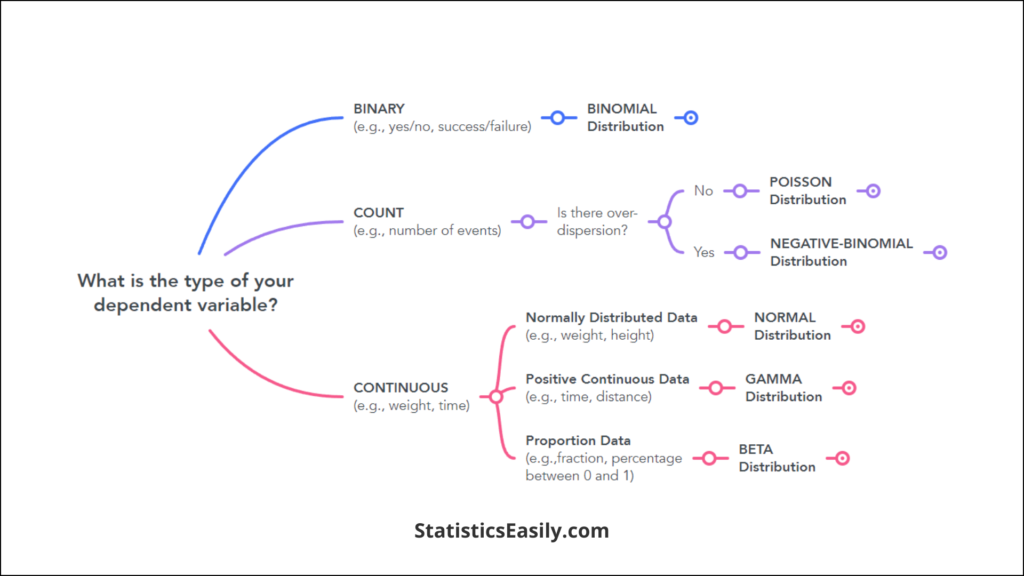
Seleccionar laFunción de enlace y distribución del modelo lineal generalizadoadecuadas es fundamental para el éxito de su análisis estadístico. La naturaleza de su variable de respuesta y la relación entre esta y las variables predictoras guían esta selección. Aquí le ofrecemos una guía detallada para ayudarle a comprender este proceso crucial.
Paso 1: Identificar el tipo de variable de respuesta
El primer paso para elegir la distribución adecuada es identificar claramente el tipo de datos con los que estás trabajando:
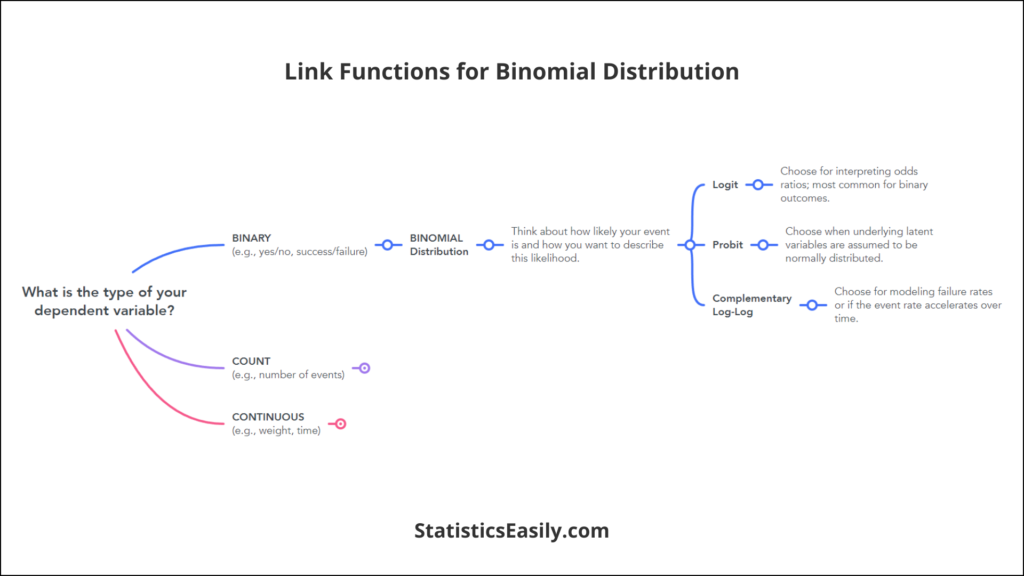
- Datos binarios: Para los resultados que caen en una de dos categorías (por ejemplo, éxito/fracaso, sí/no), eldistribución binomiales la opción preferida. Esta distribución modela el número de éxitos en una serie de ensayos independientes.
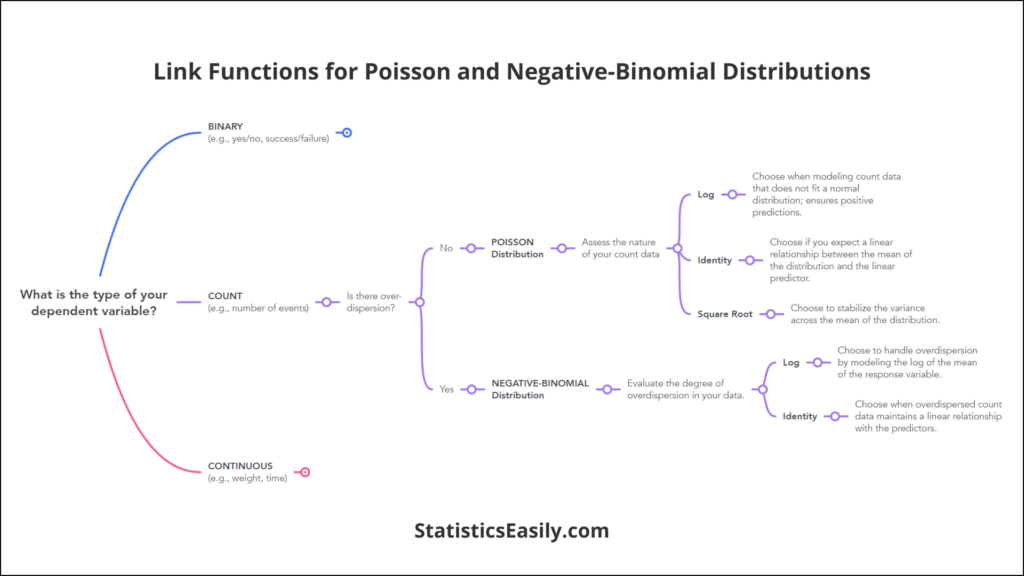
- Contar datos: Losdistribución de venenose utiliza normalmente cuando se trata de sucesos contables (por ejemplo, el número de eventos en un tiempo o espacio determinado). Es ideal para datos que representan recuentos y son números enteros no negativos.
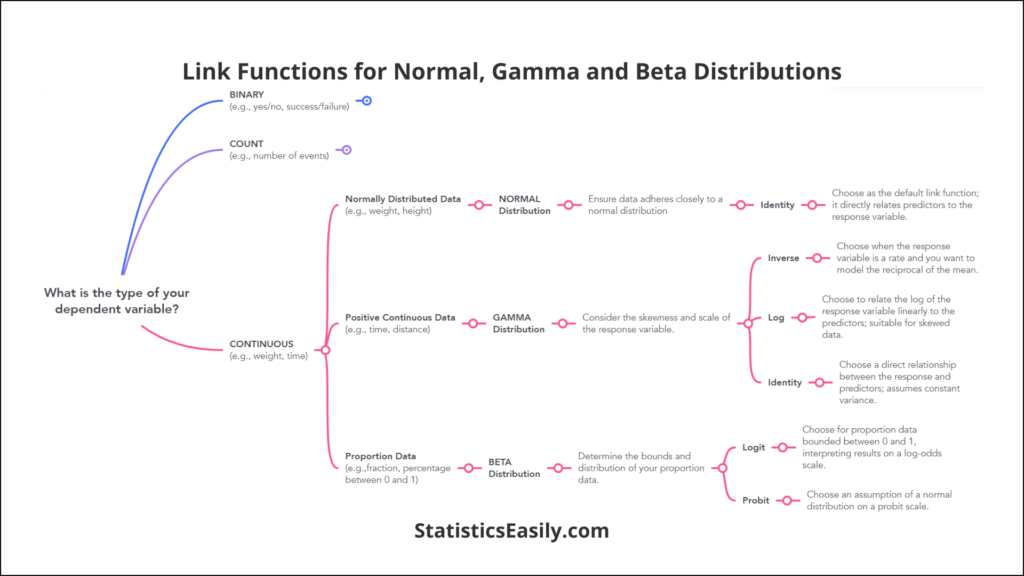
- Datos continuos: LosDistribución Gammasuele ser adecuado para datos que toman cualquier valor dentro de un rango, especialmente números positivos como duraciones o cantidades. Se utiliza para modelar datos sesgados positivamente.
- Datos normalmente distribuidos: Cuando sus datos siguen aproximadamente una distribución normal, especialmente en el caso de resultados continuos que pueden tomar valores tanto positivos como negativos, elDistribución normalse puede aplicar dentro del marco GLM.
Paso 2: comprender la relación entre variables
La función de enlace conecta el predictor lineal con la media de la distribución de respuesta. Debe elegirse en función de cómo espera que los cambios en sus predictores influyan en la variable de respuesta:
- Para datos binarios: Losenlace logitLa función se usa comúnmente, transformando la combinación lineal de predictores para que se encuentre entre 0 y 1, representando así probabilidades.
- Para datos de recuento: LosEnlace de registroLa función es una elección natural, especialmente con la distribución de Poisson, lo que garantiza que las predicciones sean siempre positivas y adecuadas para los datos de recuento.
- Para datos continuos con sesgo positivo (Gamma): Losenlace inversoLa función puede ser útil al modelar tasas o tiempos, asegurando predicciones positivas.
- Para datos normalmente distribuidos: LosEnlace de identidadA menudo se utiliza la función, que implica una relación directa entre los predictores y la variable de respuesta. Esta sencilla función implica que el valor esperado de la respuesta es igual al predictor lineal.
Paso 3: Aplicar el diagnóstico del modelo
Después de seleccionar una función de enlace y distribución preliminar según los criterios anteriores, es fundamental validar su elección mediante el diagnóstico del modelo:
- Análisis residual: Examine los residuos en busca de patrones que puedan sugerir un ajuste deficiente, lo que indica la necesidad de una distribución o función de enlace diferente.
- Pruebas de bondad de ajuste: Utilice pruebas como Deviance o AIC para evaluar qué tan bien su modelo se ajusta cuantitativamente a los datos. Estas pruebas pueden guiarlo a comparar diferentes modelos o configuraciones para encontrar el que mejor se ajuste.
Refinamiento iterativo
El proceso de selección de la función de enlace y distribución adecuada suele ser iterativo. Según los diagnósticos, es posible que deba revisar sus opciones, probar diferentes distribuciones o funciones de enlace hasta que los diagnósticos indiquen que encajan bien.
Si sigue estos pasos detallados, estará mejor equipado para seleccionar la distribución y la función de enlace más apropiadas para su GLM, mejorando la precisión y la interpretabilidad del modelo.
| Tipo de variable de respuesta | Distribución sugerida | Funciones de enlace comunes | Caso de uso |
|---|---|---|---|
| Resultado binario (p. ej., éxito/fracaso) | Binomial | Logit, Probit, Log-Log complementario | Modelar probabilidades de resultados binarios, como la presencia/ausencia de una enfermedad. |
| Contar datos (p. ej., número de eventos) | Poisson | Registro, identidad, raíz cuadrada | Contar ocurrencias en intervalos fijos, como la cantidad de llamadas recibidas por un call center por hora. |
| Contar datos con sobredispersión | Binomial Negativo | Registro, Identidad | Cuente los datos que muestren una variabilidad que supere los supuestos de Poisson, como el número de reclamaciones de seguro por cliente. |
| Proporciones continuas | Beta | Logit, Probit | Proporciones que varían entre 0 y 1, como la fracción de un área afectada por una determinada condición. |
| Datos continuos positivos | Gamma | Inversa, Registro, Identidad | Modelar tiempos de espera o tiempos de atención, donde la variable respuesta sea siempre positiva. |
| Datos normalmente distribuidos | Normal (gaussiano) | Identidad | Resultados continuos que están distribuidos simétricamente, como puntuaciones de exámenes o alturas. |
Consejos prácticos para la optimización de GLM
Implementar modelos lineales generalizados (GLM) de forma eficaz enRyPythonrequiere comprender los matices de estas potentes herramientas. Al utilizar adecuadamente laFunción de enlace y distribución del modelo lineal generalizado, puede refinar sus modelos para lograr mayor precisión y mejor interpretabilidad. A continuación, le ofrecemos algunos consejos prácticos para guiarle en este proceso:
Mejores prácticas para implementar GLM en R:
1. Utilice la‘glm()‘función' : La función 'glm()' de R es versátil y permite especificar la fórmula del modelo, la familia de distribución y la función de enlace. Por ejemplo, 'glm(response ~ predictors, family=binomial(link=”logit”), data=mydata)' ajustará un modelo de regresión logística.
2. Diagnóstico con‘plot()‘y‘summary()': Después de ajustar su modelo, utilice 'summary(glm_model)' para obtener un resumen detallado de los coeficientes del modelo, los niveles de significancia y más. La función 'plot(glm_model)' puede proporcionar gráficos de diagnóstico para evaluar el ajuste y verificar los supuestos.
3. Selección de modelos con AIC: Utilice la función 'step()' para realizar una selección de modelos paso a paso basada en el Criterio de Información de Akaike (AIC), lo que le ayudará a elegir un modelo que equilibre la complejidad con la bondad de ajuste.
4. Validación cruzada: Para la validación del modelo, considere utilizar paquetes como 'caret' o 'cv.glm()' del paquete boot para realizar la validación cruzada y evaluar el rendimiento predictivo del modelo.
Mejores prácticas para implementar GLM en Python:
1. Utilice‘statsmodels‘información‘scikit-learn': Python ofrece varias bibliotecas para la implementación de modelos lineales generalizados (GLM). Para un enfoque más estadístico, 'statsmodels' proporciona resúmenes y diagnósticos detallados. Para un enfoque de aprendizaje automático, 'scikit-learn' ofrece simplicidad e integración con flujos de trabajo de aprendizaje automático.
2. Ajuste del modelo con‘statsmodels': Utilice 'statsmodels.api.GLM' para ajustar un GLM, especificando la familia y la función de enlace. Por ejemplo, 'GLM(y, X, family=sm.families.Binomial(sm.families.links.logit)).fit()' ajusta una regresión logística.
3. Diagnóstico y validación: Utilice 'statsmodels‘ ' para técnicas como la validación cruzada.sklearn.model_selection‘ para técnicas como la validación cruzada.
4. Selección de características: En 'scikit-learn', puede utilizar técnicas de regularización disponibles en las implementaciones de regresión logística ('LogisticRegressionCV') para realizar la selección de características y evitar el sobreajuste.
Refinamiento del modelo mediante distribución y función de enlace:
Refinamiento iterativo: La creación de modelos es un proceso iterativo. Comience con un modelo simple y aumente gradualmente su complejidad. Utilice herramientas de diagnóstico en cada paso para evaluar el rendimiento del modelo y tomar decisiones informadas sobre sus modificaciones.
Selección de la distribución: Elija la distribución que mejor se ajuste a la naturaleza de su variable de respuesta. Para resultados binarios, comience con una distribución binomial; para datos de conteo, considere la distribución de Poisson o la binomial negativa en caso de sobredispersión.
Elección de la función de enlace: La función de enlace debe reflejar la relación entre los predictores lineales y la escala de respuesta. Por ejemplo, utilice una función de enlace logit para probabilidades en un modelo binomial o una función de enlace logarítmica para datos de conteo en un modelo de Poisson.
Validación y diagnóstico: Realice diagnósticos periódicos del modelo para detectar problemas como la no linealidad, puntos de alto apalancamiento o heterocedasticidad. Utilice gráficos de residuos, gráficos de influencia y la distancia de Cook para identificar posibles problemas.
Título del anuncio
Descripción del anuncio. Lorem ipsum dolor sit amet, consectetur adipiscing elit.
Conclusión
Al concluir nuestro recorrido por las complejidades deFunción de enlace y distribución del modelo lineal generalizadola selección de la función de enlace, es fundamental repasar las ideas clave que mejoran la precisión de nuestros modelos estadísticos y la profundidad de nuestros análisis. Esta guía ha iluminado el camino para aprovechar todo el potencial de los modelos lineales generalizados, haciendo hincapié en la importancia de adaptar los componentes del modelo a las características inherentes de los datos.
Puntos clave:
Enfoque personalizado: La clave de la optimización de los modelos lineales generalizados (GLM) reside en la selección cuidadosa de la distribución y la función de enlace, adaptadas a la naturaleza de la variable de respuesta y a la relación esperada con las variables predictoras. Desde resultados binarios que requieren una distribución binomial con una función de enlace logit hasta datos de conteo que se modelan mejor con una distribución de Poisson y una función de enlace logarítmica, cada elección desempeña un papel fundamental en la precisión del modelo.
Diagnóstico e iteración: El proceso no termina con la selección inicial. El diagnóstico es fundamental para refinar el modelo, y el análisis de residuos y las pruebas de bondad de ajuste guían los ajustes iterativos para garantizar el mejor ajuste posible del modelo.
Aplicación en el mundo real: La verdadera prueba de estos principios reside en su aplicación a datos reales. La versatilidad de los modelos lineales generalizados (GLM) permite adaptarlos a una amplia gama de escenarios, desde estudios epidemiológicos que predicen la incidencia de enfermedades hasta modelos econométricos que evalúan las tendencias del mercado.
Artículos recomendados
Descubra más información y técnicas avanzadas en nuestra completa colección de artículos sobre modelado estadístico y análisis de los datos . Profundice en el mundo de la ciencia de datos con nuestros guías expertos.
- Navegando por los conceptos básicos de los modelos lineales generalizados: una introducción completa
- Guía de selección de funciones de enlace y distribución del modelo lineal generalizado (GLM)
- Comprensión de las distribuciones de modelos lineales generalizados
- El papel de las funciones de enlace en modelos lineales generalizados
Preguntas Frecuentes (FAQ)
P1: ¿Qué es un modelo lineal generalizado (GLM)?Un GLM es una generalización flexible de la regresión lineal ordinaria que permite que las variables de respuesta tengan modelos de distribución de errores distintos de la distribución normal.
P2: ¿Por qué es importante elegir la distribución correcta en los GLM?Seleccionar la distribución adecuada ayuda a modelar con precisión los datos, reflejando su estructura subyacente y su variabilidad.
P3: ¿Qué son las funciones de enlace en los GLM?Las funciones de enlace definen la relación entre el predictor lineal y la media de la función de distribución.
P4: ¿Cómo selecciono la función de enlace adecuada para mi GLM?La elección de la función de enlace depende de la naturaleza de la variable dependiente y de la distribución de los datos.
P5: ¿Puedo usar varias distribuciones en un solo GLM?Normalmente se elige una sola distribución para que se ajuste mejor a los datos en un GLM, pero los modelos complejos pueden integrar varias distribuciones.
P6: ¿Cuál es la distribución más común utilizada en los GLM?La distribución binomial se utiliza ampliamente para datos binarios, mientras que la distribución normal es típica para datos continuos.
P7: ¿Qué papel juegan los diagnósticos en la selección de la distribución y la función de enlace de los modelos lineales generalizados (GLM)?Los diagnósticos ayudan a evaluar el ajuste del modelo, identificar la presencia de valores atípicos y guiar el proceso de selección.
P8: ¿Pueden las herramientas de software ayudar a seleccionar la distribución y la función de enlace del GLM?Sí, programas estadísticos como R y Python ofrecen paquetes que facilitan la selección y evaluación de los GLM.
P9: ¿Cómo afecta la elección de la función de enlace a la interpretación del modelo?La función de enlace influye en cómo se interpretan los coeficientes del modelo, afectando la claridad y la inmediatez de las conclusiones.
P10: ¿Puedo cambiar la distribución y la función de enlace después del ajuste del modelo?Sí, el refinamiento del modelo a menudo implica probar iterativamente diferentes distribuciones y funciones de enlace para mejorar el ajuste y la precisión.