¿Qué es el análisis de regresión? Una guía completa para principiantes
El análisis de regresión es una técnica estadística que se utiliza para modelar la relación entre la variable dependiente y una o más variables independientes, lo que permite la predicción, la toma de decisiones y la comprensión en varios campos.
Destacados
- El análisis de regresión modela las relaciones entre variables dependientes e independientes para la predicción y la toma de decisiones.
- Lineal, logística y polinómica son tipos clave de regresión, cada uno de ellos adecuado para diferentes datos y objetivos.
- Las métricas de bondad de ajuste, como R-cuadrado y R-cuadrado ajustado, evalúan el rendimiento y la explicabilidad del modelo.
- Los supuestos de regresión incluyen linealidad, normalidad, independencia de errores y homocedasticidad, que deben validarse.
- Los errores comunes incluyen correlación confusa con causalidad, sobreajuste, multicolinealidad, sesgo de variable omitida y extrapolación.
Título del anuncio
Descripción del anuncio. Lorem ipsum dolor sit amet, consectetur adipiscing elit.
¿Qué es el análisis de regresión?
El análisis de regresión es una técnica fundamental en estadística y ciencia de datos que nos permite explorar y cuantificar las relaciones entre variables. Se utiliza para predecir resultados, identificar tendenciasy tomar decisions basadas en datos en diversos campos, desde los negocios y las finanzas hasta la sanidad y la ingeniería.
En esencia, el análisis de regresión busca modelar la relación entre una variable dependiente (la variable que intentamos predecir o explicar) y una o más variables independientes (los factores que influyen en la variable dependiente). De esta manera, podemos comprender mejor los patrones subyacentes y las relaciones causales de nuestros datos, lo que nos permite realizar mejores predicciones y más informadas decisions.
La idea fundamental del análisis de regresión es encontrar el modelo que mejor se ajuste y represente con precisión la relación entre las variables dependientes e independientes. Esto suele implicar ajustar una línea o curva a los puntos de datos para minimizar las diferencias entre los valores observados y predichos, conocidas como residuos.
En la práctica, el análisis de regresión puede adoptar muchas formas, desde Regresión lineal simple, que modela la relación entre una variable dependiente y una independiente, hasta técnicas más avanzadas, como la regresión polinómica múltiple, que permiten el análisis de relaciones más complejas.
Como un versátil y poderoso Como herramienta estadísticaversátil y potente , el análisis de regresión es esencial para quienes buscan comprender los datos y extraer conclusiones relevantes. En esta guía, aprenderá sobre los distintos tipos de análisis de regresión, sus conceptosfundamentales , supuestos y limitacionesy aplicaciones prácticas en diversos sectores. Al comprender qué es el análisis de regresión y dominar sus técnicas, estará bien preparado para afrontar desafíos complejos con datos y tomar decisiones basadas en datos con confianza.
Tipos de análisis de regresión
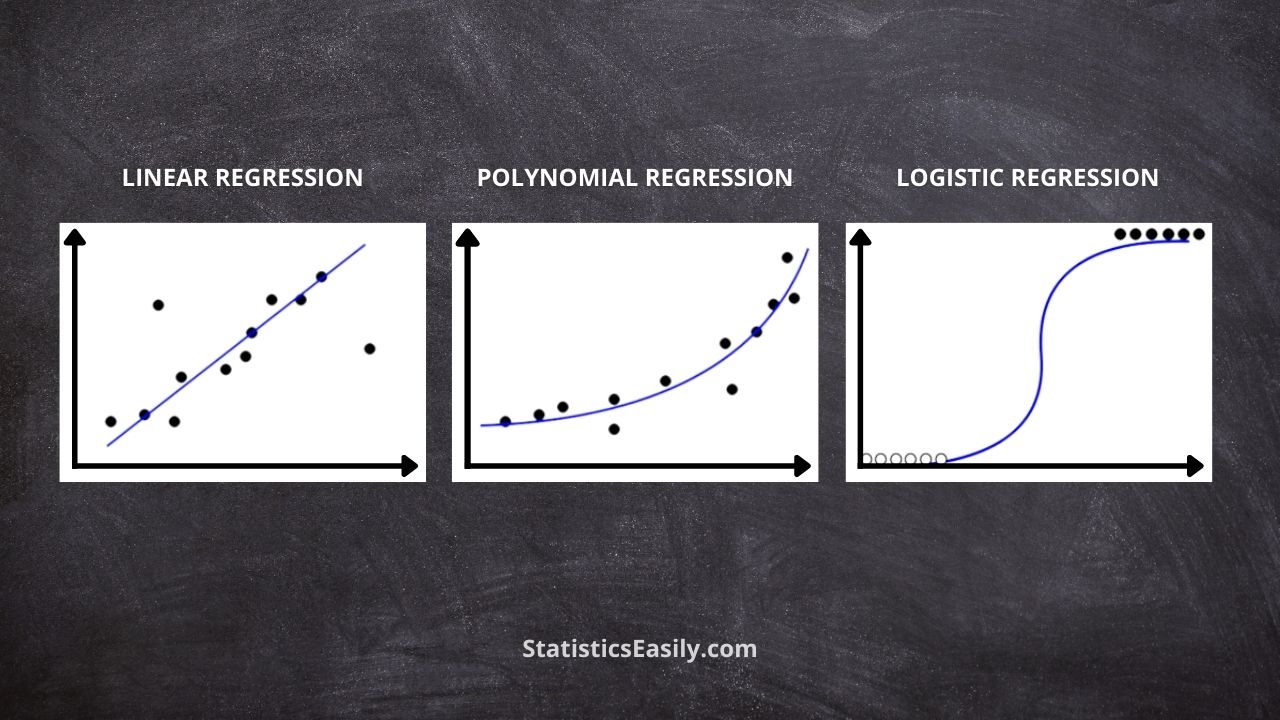
Regresión lineal:Esta es la forma más básica de análisis de regresión para modelar la relación entre las variables dependientes e independientes. Presupone una relación lineal entre las variables, representada por una línea recta. El objetivo es encontrar la línea que mejor se ajuste, minimizando la suma de las diferencias al cuadrado entre los valores observados y predichos. La regresión lineal se utiliza ampliamente para pronósticos, análisis de tendencias e identificación del impacto de una variable sobre otra.
Regresión logística:Este es un tipo de análisis de regresión diseñado para problemas con variables dependientes categóricas, incluyendo binarias (dos resultados posibles), nominales (categorías no ordenadas) y ordinales (categorías ordenadas). En lugar de predecir el valor real de la variable dependiente, la regresión logística estima la probabilidad de que ocurra un evento en función de la variable independiente. Emplea la función logística, que transforma el resultado del modelo de regresión en un valor de probabilidad entre 0 y 1. De uso común en campos como la investigación médica, el marketing y las finanzas, la regresión logística es versátil para predecir la probabilidad de eventos o resultados específicos y comprender el impacto de diversos factores en dichos resultados.
Regresión polinómica:Esta es una extensión de la regresión lineal que se utiliza cuando la relación entre las variables dependientes e independientes no es lineal. En lugar de ajustar una línea recta, se utiliza una función polinómica para modelar la curvatura de la relación. La regresión polinómica puede capturar patrones más complejos en los datos, proporcionando un mejor ajuste en situaciones donde los modelos lineales son inadecuados. Sin embargo, es fundamental ser cauteloso con la elección de los grados polinómicos, ya que los modelos excesivamente complejos pueden llevar al sobreajuste y a una mala generalización de nuevos datos.
*Regresión múltiple: La regresión múltiple es una técnica avanzada que permite incluir múltiples variables independientes, posibilitando el análisis de relaciones más complejas entre variables y el control de factores de confusión. No se trata simplemente de una generalización de la regresión lineal, sino que también puede extenderse a otros tipos de regresión, como la logística y la polinómica. El objetivo de la regresión múltiple es encontrar el modelo que mejor se ajuste a los datos para explicar la relación entre las variables dependientes e independientes.
Los conceptos fundamentales del análisis de regresión
Variables dependientes e independientes:En el análisis de regresión, la variable dependiente (la variable de respuesta o variable objetivo) es el resultado que intentamos predecir o explicar. Por otro lado, las variables independientes (también conocidas como predictores, características o variables explicativas) son los factores que influyen en la variable dependiente. El análisis de regresión busca modelar la relación entre estas variables, lo que nos permite comprender los efectos de las variables independientes sobre la variable dependiente y realizar predicciones.
Coeficientes e Interceptos:Los coeficientes y los interceptos son componentes esenciales de un modelo de regresión. Los coeficientes representan el efecto de las variables independientes sobre la variable dependiente, indicando cuánto cambia esta última por cada unidad de incremento en las variables independientes, suponiendo que todas las demás variables se mantienen constantes. El intercepto representa el valor esperado de la variable dependiente cuando todas las variables independientes son iguales a cero. Estos valores se estiman mediante técnicas de mínimos cuadrados ordinarios o de máxima verosimilitud durante el ajuste del modelo.
Bondad de ajuste y R cuadrado: La bondad de ajuste mide qué tan bien se ajusta el modelo de regresión a los datos observados. Se pueden usar varias métricas para evaluar la bondad de ajuste. Sin embargo, una de las más comunes es el R cuadrado (también conocido como coeficiente de determinación). El R cuadrado representa la proporción de la varianza en la variable dependiente explicada por las variables independientes del modelo. Varía entre 0 y 1, donde los valores más altos indican un mejor ajuste. En la regresión múltiple, es esencial considerar el R cuadrado ajustado, que tiene en cuenta el número de variables independientes en el modelo. El valor de R cuadrado puede aumentar a medida que se agregan más variables, incluso si las variables adicionales no contribuyen significativamente al poder predictivo del modelo. El R cuadrado ajustado corrige este problema penalizando el valor de R cuadrado por la inclusión de variables innecesarias. Esto resulta en una evaluación más precisa del rendimiento del modelo y ayuda a prevenir el sobreajuste. Sin embargo, tanto el R cuadrado como el R cuadrado ajustado deben interpretarse con precaución, ya que un valor alto no garantiza un buen modelo. El modelo aún puede ser susceptible a problemas como la multicolinealidad, el sesgo por variables omitidas u otras violaciones de los supuestos de regresión.
Título del anuncio
Descripción del anuncio. Lorem ipsum dolor sit amet, consectetur adipiscing elit.
Supuestos y limitaciones clave
El análisis de regresión se basa en varios supuestos clave comunes a los diferentes tipos de regresión, incluidas las extensiones de regresión lineal, logística, polinómica y múltiple. Si no se cumplen estos supuestos, la precisión y validez de las predicciones y conclusiones del modelo pueden ser limitadas. Por lo tanto, es fundamental comprender y evaluar estos supuestos al realizar un análisis de regresión.
Forma funcional apropiada:La relación entre las variables dependientes e independientes debe seguir la forma funcional del modelo de regresión. Esto significa una relación lineal para la regresión lineal, mientras que se asume una relación polinómica para la regresión polinómica. El análisis de diagramas de dispersión o gráficos de residuos puede ayudar a identificar incumplimientos de este supuesto.
Independencia de las observaciones:Las observaciones en un conjunto de datos deben ser independientes entre sí. En la autocorrelación (cuando las observaciones consecutivas están relacionadas), el modelo de regresión puede subestimar la variabilidad real de los datos, lo que conlleva estimaciones de coeficientes y pruebas de hipótesis poco fiables.
Independencia de los errores:Los residuos (errores) deben ser independientes, lo que significa que el error de una observación no debe influir en el error de otra. Si los errores están correlacionados, los errores estándar de los coeficientes pueden subestimarse, lo que conlleva inferencias e intervalos de confianza incorrectos.
Homocedasticidad (para regresión lineal y polinómica):La varianza residual debe ser constante en todos los niveles de las variables independientes. Si la varianza cambia (fenómeno denominado heterocedasticidad), los errores estándar de los coeficientes pueden estar sesgados, lo que afecta a las pruebas de hipótesis y a los intervalos de confianza.
Normalidad de los residuos (para regresión lineal y polinómica):Los residuos (es decir, las diferencias entre los valores observados y predichos) deben seguir una distribución normal. Las violaciones de la normalidad pueden afectar las pruebas de hipótesis y la validez de los intervalos de confianza.
Ausencia de multicolinealidad:Las variables independientes no deben estar altamente correlacionadas entre sí. La multicolinealidad puede provocar estimaciones de coeficientes inestables y dificultar la interpretación de las contribuciones individuales de cada variable.
Función de enlace correctamente especificada (para regresión logística):La función de enlace debe definirse correctamente en la regresión logística para transformar los valores predichos en probabilidades. El uso de una función de enlace incorrecta puede generar estimaciones de coeficientes sesgadas y predicciones inexactas.
Interpretación de los resultados del análisis de regresión
Comprender e interpretar los resultados del análisis de regresión es crucial para tomar mejores decisiones y sacar conclusiones significativas. A continuación se presentan algunos aspectos clave a considerar al interpretar los resultados de cualquier modelo de regresión, incluida la regresión lineal, logística, polinómica y múltiple:
Estimación de coeficientes:Los coeficientes representan el efecto de cada variable independiente sobre la variable dependiente, manteniendo constantes las demás variables. En la regresión lineal y polinómica, los coeficientes indican el cambio en la variable dependiente ante un incremento unitario en la variable independiente. En la regresión logística, los coeficientes representan el cambio en el logaritmo de las probabilidades del resultado ante un incremento unitario en la variable independiente.
Significancia de los coeficientes:Se realizan pruebas de hipótesis, como pruebas t o pruebas z, para determinar la significancia estadística de los coeficientes. Un coeficiente estadísticamente significativo sugiere que la variable independiente tiene un impacto significativo en la variable dependiente. Un coeficiente no significativo implica que la variable independiente podría no contribuir significativamente al modelo.
Intervalos de confianza:Los intervalos de confianza estiman el rango dentro del cual es probable que se encuentre el coeficiente poblacional. Los intervalos más estrechos sugieren estimaciones más precisas, mientras que los intervalos más amplios indican una mayor incertidumbre.
Estadísticas de ajuste del modelo:Las métricas de bondad de ajuste, como el coeficiente de determinación (R²), el coeficiente de determinación ajustado (R² ajustado) o el criterio de información de Akaike (AIC), pueden ayudar a evaluar el rendimiento general del modelo. Estas métricas deben considerarse junto con otras medidas de diagnóstico y gráficos para evaluar la adecuación del modelo.
Análisis de residuos:El análisis de los residuos puede revelar patrones o tendencias que sugieren incumplimientos de los supuestos de regresión o áreas donde el modelo no se ajusta bien a los datos. Los gráficos de residuos, los gráficos de probabilidad normal y los gráficos de autocorrelación pueden utilizarse para diagnosticar posibles problemas y orientar la mejora del modelo.
Valores atípicos y puntos influyentes:Los valores atípicos y los puntos influyentes pueden afectar significativamente el modelo de regresión. Identificar y abordar estas observaciones, excluyéndolas o utilizando técnicas de regresión robusta, puede ayudar a mejorar el rendimiento del modelo.
Validación y generalización: La validación cruzada o la validación por retención pueden utilizarse para evaluar el rendimiento del modelo con datos nuevos, lo que ayuda a medir su capacidad de generalización y a prevenir el sobreajuste.
Título del anuncio
Descripción del anuncio. Lorem ipsum dolor sit amet, consectetur adipiscing elit.
Aplicaciones prácticas del análisis de regresión
El análisis de regresión es una poderosa herramienta estadística con muchas aplicaciones prácticas en diversas industrias. El análisis de regresión puede ayudar a informar la toma de decisiones, optimizar procesos y predecir resultados futuros modelando la relación entre las variables dependientes e independientes. A continuación se muestran algunos ejemplos de cómo se utiliza el análisis de regresión en diversas industrias:
Finanzas y Economía:En finanzas, el análisis de regresión se utiliza para modelar la relación entre los precios de las acciones y los indicadores económicos, como las tasas de interés o las tasas de desempleo. Esto puede ayudar a los inversores a tomar mejores decisiones sobre la asignación de cartera y la gestión de riesgos. Además, los economistas pueden utilizar la regresión para estudiar el impacto de las políticas monetarias y fiscales en el crecimiento económico y la inflación.
Marketing y Ventas:Los modelos de regresión pueden utilizarse para analizar la efectividad de las campañas de marketing, comprender el comportamiento del consumidor y predecir las ventas. Por ejemplo, las empresas pueden usar la regresión para determinar el impacto del gasto en publicidad sobre las ventas, lo que les permite optimizar su presupuesto de marketing para obtener el máximo retorno de la inversión.
Cuidado de la salud:el análisis de regresión explora la relación entre las características del paciente y los resultados de salud. Esto puede ayudar a identificar factores de riesgo de enfermedades, fundamentar las decisiones de tratamiento y optimizar la atención al paciente. Por ejemplo, la regresión logística puede predecir la probabilidad de que un paciente desarrolle una determinada afección en función de variables demográficas y clínicas.
Fabricación y control de calidad:El análisis de regresión permite optimizar los procesos de fabricación, mejorar la calidad del producto y reducir los costos de producción. Al modelar la relación entre las variables del proceso y las características del producto, las empresas pueden identificar las condiciones óptimas para lograr las especificaciones deseadas, minimizando al mismo tiempo el desperdicio y el consumo de recursos.
Recursos Humanos:En la gestión de recursos humanos, el análisis de regresión puede utilizarse para comprender los factores que influyen en el desempeño, la retención y la satisfacción laboral de los empleados. Esto puede ayudar a las organizaciones a desarrollar estrategias específicas de reclutamiento, capacitación y compromiso de los empleados, lo que en última instancia mejora la productividad y reduce la rotación de personal.
Análisis deportivo:Los modelos de regresión se utilizan cada vez más en el análisis deportivo para evaluar el rendimiento de los jugadores, fundamentar las decisiones de los entrenadores y optimizar las estrategias de los equipos. Por ejemplo, el análisis de regresión múltiple puede cuantificar la contribución de las estadísticas individuales de los jugadores al éxito del equipo, lo que ayuda a los entrenadores y directivos a tomar decisiones más acertadas sobre la plantilla.
Ciencia Ambiental: En la investigación ecológica, el análisis de regresión se puede utilizar para modelar la relación entre factores ambientales, como la temperatura o la precipitación, y resultados ecológicos, como la distribución de especies o la productividad del ecosistema. Esto puede servir de base para las iniciativas de conservación, la gestión de los recursos naturales y el desarrollo de políticas.
Errores y conceptos erróneos comunes en el análisis de regresión
Si bien el análisis de regresión es una herramienta estadística poderosa y ampliamente utilizada, presenta desafíos y peligros potenciales. Ser consciente de estos problemas y conceptos erróneos comunes puede ayudar a los profesionales a evitar errores y mejorar la calidad de sus análisis:
Correlación vs. causalidad:Un error común en el análisis de regresión es creer que la correlación implica causalidad. Si bien la regresión puede identificar relaciones entre variables, no necesariamente demuestra un vínculo causal. Establecer la causalidad requiere una comprensión más profunda de los mecanismos subyacentes y, a menudo, implica diseños experimentales o análisis adicionales.
Sobreajuste:Construir un modelo demasiado complejo o con demasiadas variables independientes puede provocar sobreajuste, donde el modelo captura el ruido de los datos en lugar de las relaciones subyacentes. Los modelos sobreajustados tienen un rendimiento deficiente con datos nuevos y pueden llevar a conclusiones erróneas. Para evitar el sobreajuste, considere utilizar validación cruzada, regularización o selección de modelos basada en criterios de información como AIC o BIC.
Multicolinealidad:Cuando las variables independientes están altamente correlacionadas, resulta difícil interpretar la contribución individual de cada variable al modelo. La multicolinealidad puede generar estimaciones inestables y errores estándar inflados. Detectar la multicolinealidad mediante factores de inflación de la varianza (VIF) o matrices de correlación, y abordarla mediante técnicas como la selección de variables o la reducción de dimensionalidad, puede mejorar la interpretación y el rendimiento del modelo.
Sesgo por variables omitidas:Excluir variables importantes del modelo de regresión puede generar estimaciones de coeficientes sesgadas y conclusiones erróneas. Para evitar este sesgo, asegúrese de incluir todas las variables relevantes en el análisis. Considere utilizar técnicas de regresión por pasos o selección de modelos para identificar los predictores más importantes.
Incumplimiento de supuestos:Ignorar o no comprobar los supuestos subyacentes del análisis de regresión puede conducir a resultados poco fiables. Es fundamental evaluar la validez de los supuestos, como la linealidad, la independencia de los errores y la homocedasticidad, y emplear técnicas o transformaciones alternativas si fuera necesario.
Extrapolación:Utilizar modelos de regresión para realizar predicciones más allá del rango de los datos observados puede ser arriesgado, ya que las relaciones entre variables podrían no mantenerse en regiones no observadas. Se recomienda precaución al extrapolar predicciones y considerar las limitaciones del modelo y la posibilidad de que factores imprevistos influyan en el resultado.
Interpretación errónea de los coeficientes: Interpretar los coeficientes de regresión sin considerar la escala de las variables o la función de enlace (en el caso de la regresión logística) puede generar confusión y conclusiones incorrectas. Asegúrese de que la interpretación de los coeficientes sea apropiada para el contexto y tenga en cuenta las unidades de medida, la dirección del efecto y la magnitud de la relación.
Título del anuncio
Descripción del anuncio. Lorem ipsum dolor sit amet, consectetur adipiscing elit.
Conclusión
El análisis de regresión es una herramienta estadística poderosa y versátil que permite a los profesionales modelar las relaciones entre variables, hacer predicciones e informar la toma de decisiones en diversas industrias. Al comprender los conceptos fundamentales, como variables dependientes e independientes, coeficientes y bondad de ajuste, los analistas pueden seleccionar el tipo apropiado de modelo de regresión para sus datos, incluida la regresión lineal, logística, polinómica y múltiple.
Sin embargo, es fundamental ser consciente de los supuestos y limitaciones del análisis de regresión e interpretar cuidadosamente los resultados para evitar errores y conceptos erróneos comunes. Al considerar los supuestos, abordar cuestiones como la multicolinealidad y el sobreajuste, y utilizar técnicas como la validación cruzada y la regularización, los profesionales pueden construir modelos más precisos y generalizables que aporten conocimientos valiosos e impulsen la toma de decisiones basada en datos.
En resumen, el análisis de regresión es una herramienta invaluable para comprender relaciones complejas y resolver problemas del mundo real, siempre que los profesionales sean conscientes de sus posibles desafíos y limitaciones y se comprometan a utilizar el método de manera responsable y efectiva.
Artículos recomendados
¿Listo para ampliar tus conocimientos? Visita nuestro blog para leer artículos más relevantes y profundizar tu comprensión de estas pruebas estadísticas cruciales. Aprovecha la oportunidad para mejorar tus habilidades análisis de los datos y tomar decisiones más informadas. ¡Lee ahora!
- Cómo informar los resultados de una regresión lineal múltiple en estilo APA
- Cómo informar resultados de regresión lineal simple en estilo APA
- Supuestos en regresión lineal: una guía completa
- Regresión logística usando R: la guía definitiva
- ¿Cuáles son los supuestos de la regresión logística?
- ¿Cuáles son los 3 tipos de regresión logística?
- Cómo crear líneas de regresión en Excel
- Dominar la regresión logística (Historia)
Preguntas frecuentes: ¿Qué es el análisis de regresión?
El análisis de regresión es un enfoque estadístico para modelar relaciones entre variables dependientes e independientes para la predicción y la toma de decisiones.
Los tipos principales son regresión lineal, logística, polinómica y múltiple, cada una adecuada para diferentes tipos de datos y objetivos.
La correlación mide la fuerza y dirección de una relación entre variables. Al mismo tiempo, la causalidad implica que una variable influye directamente en la otra.
Los supuestos incluyen linealidad, normalidad, independencia de errores y homocedasticidad, que deben validarse para obtener resultados confiables.
Cuando las variables independientes están altamente correlacionadas, se produce multicolinealidad, lo que dificulta la interpretación de las contribuciones individuales. Puede abordarse utilizando técnicas de selección de variables o reducción de dimensionalidad.
El sobreajuste ocurre cuando un modelo captura el ruido en lugar de las relaciones subyacentes, lo que resulta en una generalización deficiente. Se puede prevenir mediante validación cruzada, regularización o selección de modelo.
Los coeficientes representan el efecto de las variables independientes sobre la variable dependiente mientras se mantienen constantes otras variables. La interpretación depende del tipo de regresión y de las escalas de variables.
El análisis residual examina los residuos (diferencias entre los valores observados y predichos) para identificar patrones, tendencias o violaciones de los supuestos de regresión, lo que guía la mejora del modelo.
El análisis de regresión se utiliza ampliamente en finanzas, marketing, atención sanitaria, fabricación, recursos humanos, análisis deportivo y ciencias medioambientales.
Los errores comunes incluyen correlación confusa con causalidad, sobreajuste, multicolinealidad, sesgo de variable omitida, extrapolación y coeficientes de interpretación errónea.