¿Cómo calcular los residuos en el análisis de regresión?
Aprenderá los métodos precisos para calcular e interpretar residuos en el análisis de regresión para obtener información mejorada sobre los datos.
Introducción
Comprender linear regression y el papel de los residuos es fundamental en el análisis de regresión. En este artículo, profundizamos en los fundamentos de la regresión lineal, un método estadístico popular que se utiliza para modelar la relación entre una variable dependiente y una o más variables independientes. Al explorar este concepto, sentamos las bases para una comprensión más profunda del análisis de regresión.
No se puede subestimar la importancia de calcular los residuos en el análisis de regresión. Los residuos, las diferencias entre los valores observados y los valores predichos por el modelo de regresión, son indicadores clave de la precisión y eficacia del modelo. Proporcionan información valiosa sobre el desempeño del modelo y resaltan si el modelo captura adecuadamente la relación subyacente en los datos.
Destacados
- Los residuos revelan la diferencia entre los valores observados y predichos en los modelos de regresión.
- El análisis residual eficaz mejora la precisión de los modelos de regresión.
- La visualización de residuos ayuda a identificar patrones y deficiencias del modelo.
- La interpretación correcta de los residuos es crucial para diagnosticar el ajuste del modelo.
- Las técnicas avanzadas abordan la no linealidad y la heterocedasticidad en los residuos.
Título del anuncio
Descripción del anuncio. Lorem ipsum dolor sit amet, consectetur adipiscing elit.
El concepto de residuos
En el análisis de regresión, comprender el concepto de residuos es fundamental. Un residuo es la diferencia entre un valor observado y el valor predicho por un modelo de regresión. Esta discrepancia no es un simple error; tiene una importancia significativa para evaluar la efectividad de un modelo.
Los residuos sirven como indicadores críticos de la precisión del modelo. Proporcionan información sobre qué tan bien el modelo captura las tendencias de los datos subyacentes. Los residuos generalmente serán pequeños y estarán distribuidos aleatoriamente si un modelo es preciso. Por otro lado, los residuos grandes o con patrón indican que es posible que el modelo no esté representando adecuadamente los datos.
Guía paso a paso para calcular los residuos
Calcular los residuos en el análisis de regresión es un proceso sencillo pero vital. Primero, definamos la fórmula para un residuo: la diferencia entre el valor observado (y) y el valor predicho (ŷ) para cada punto de datos. Matemáticamente, se expresa como e=y−y^.
Para ilustrar este proceso, considere un modelo de regresión lineal simple y un conjunto de datos con 10 puntos de datos. Calcule el valor predicho usando la ecuación de regresión para cada punto, luego calcule el residual restando este valor predicho del valor observado.
A continuación se mostrará un ejemplo detallado, utilizando un conjunto de datos hipotético para realizar estos cálculos. Este ejemplo incluirá la creación de una tabla que enumere los valores observados, los valores predichos y los residuos calculados para cada punto de datos. Trazaremos estos residuos para evaluar visualmente su distribución y cualquier patrón que pueda sugerir insuficiencias del modelo. Esta demostración práctica tiene como objetivo proporcionar una comprensión clara de cómo calcular e interpretar residuos de manera efectiva.
A través de esta guía paso a paso, los lectores obtendrán conocimientos prácticos sobre el análisis residual, un componente clave para perfeccionar los modelos de regresión y mejorar su precisión predictiva.
Ejemplo
Hemos creado un conjunto de datos hipotético con 10 puntos de datos para nuestro ejemplo detallado. Utilizando este conjunto de datos, realizamos un análisis de regresión lineal simple, calculamos los valores predichos y derivamos los residuos. El proceso se desarrolló de la siguiente manera:
1. Creación de datos: El conjunto de datos consta de una variable independiente (X) y una variable dependiente (y). Los valores de la variable independiente varían aleatoriamente de 0 a 10, y los valores de la variable dependiente se generan para tener una relación lineal con algo de ruido aleatorio añadido para mayor realismo.
| Variable independiente (X) | Variable dependiente (y) |
|---|---|
| 5.488135 | 14.008425 |
| 7.151894 | 20.788281 |
| 6.027634 | 16.591160 |
| 5.448832 | 13.865430 |
| 4.236548 | 11.479096 |
| 6.458941 | 16.814701 |
| 4.375872 | 13.927838 |
| 8.917730 | 21.884008 |
| 9.636628 | 24.717704 |
| 3.834415 | 7.877846 |
2. Modelo de regresión lineal: Se ajustó un modelo de regresión lineal a estos datos. La ecuación del modelo se puede representar como y=β0+β1X+ϵ, donde β0 (ordenada al origen) es aproximadamente 0.71 y β1 (coeficiente) es aproximadamente 2.52.
y = 0.71 + 2.52X + ϵ
3. Valores predichos y residuos: Calculamos el valor predicho utilizando el modelo de regresión y luego determinamos el residuo de cada punto de datos (la diferencia entre el valor observado y el valor predicho).
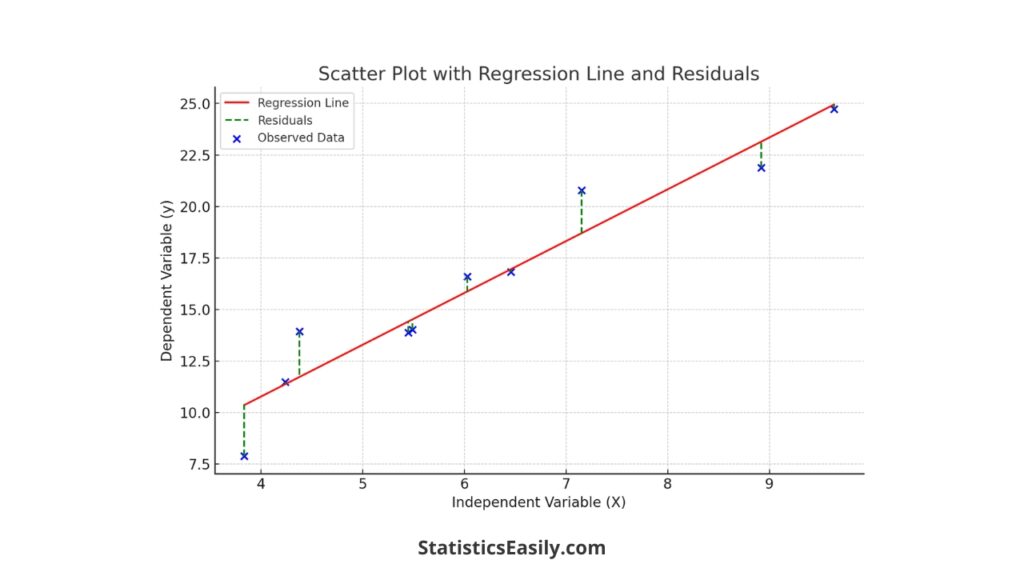
A continuación se muestra una tabla resumen que muestra los valores observados, los valores predichos y los residuos calculados para cada punto de datos:
| Valores Observados | Valores predichos | Residuos |
|---|---|---|
| 14.01 | 14.51 | -0.50 |
| 20.79 | 18.70 | 2.09 |
| 16.59 | 15.87 | 0.72 |
| 13.87 | 14.41 | -0.55 |
| 11.48 | 11.36 | 0.12 |
| 16.81 | 16.95 | -0.14 |
| 13.93 | 11.71 | 2.21 |
| 21.88 | 23.14 | -1.25 |
| 24.72 | 24.95 | -0.23 |
| 7.88 | 10.35 | -2.47 |
Gráfico de residuos: Este gráfico representa visualmente los residuos en función de la variable independiente. Una línea horizontal en cero indica dónde se encontrarían los residuos si el modelo predijera los valores a la perfección. La dispersión de los puntos alrededor de esta línea ayuda a evaluar el rendimiento del modelo. Podemos observar cómo se distribuyen los residuos en el gráfico y buscar patrones que puedan indicar deficiencias en el modelo.
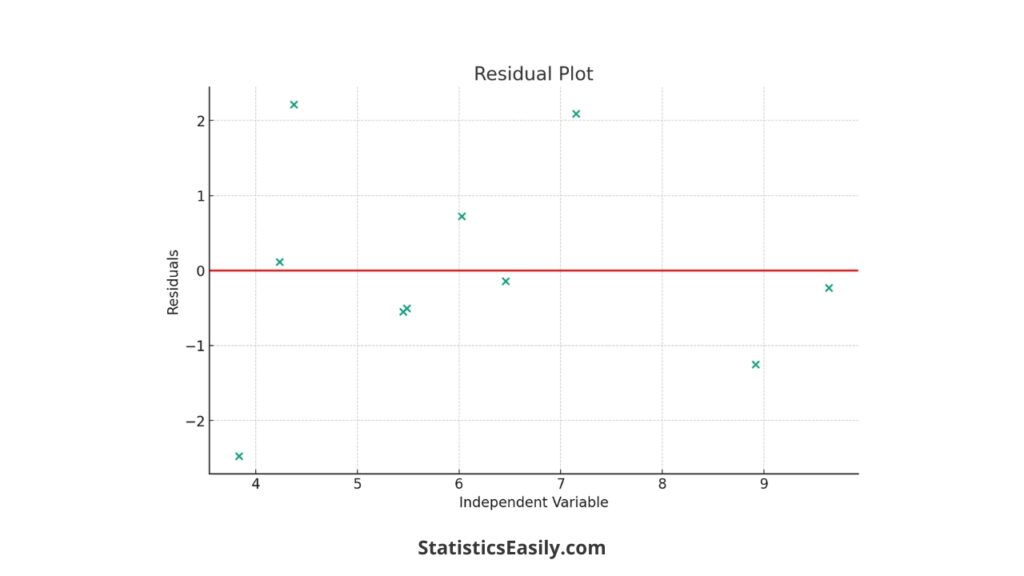
Esta guía paso a paso, con su ejemplo práctico y ayudas visuales, ilustra la importancia de calcular y analizar residuos en modelos de regresión. Mejora la comprensión del concepto y demuestra la aplicación en un contexto del mundo real.
Interpretación de residuos
Los residuos, las desviaciones de los valores observados de los valores predichos, pueden indicar qué tan bien se ajusta un modelo a los datos. Son la parte inexplicable del modelo y ofrecen una ventana a sus limitaciones y posibles mejoras.
Al analizar los residuos, se busca la aleatoriedad. Idealmente, los residuos deberían aparecer dispersos aleatoriamente alrededor del eje horizontal, lo que indica que las predicciones del modelo son insesgadas y la varianza es consistente en todos los niveles de variables independientes. Los patrones sistemáticos en los residuos, como una curva o una agrupación, pueden sugerir problemas con el modelo, como la no linealidad o la heterocedasticidad.
Diagnosticar problemas en modelos de regresión utilizando residuos implica varios pasos:
1. Inspección visual: El primer paso es crear un gráfico de residuos. Este gráfico puede ayudar a detectar problemas evidentes, como patrones o valores atípicos. Si los residuos no parecen estar distribuidos aleatoriamente, esto indica que el modelo podría no estar capturando toda la información relevante.
2. Pruebas estadísticas: Más allá de la inspección visual, las pruebas estadísticas pueden proporcionar evidencia de autocorrelación (donde los residuos de un período están relacionados con los residuos de otro) o heterocedasticidad (donde los residuos tienen una varianza no constante).
3. Comparación de modelos: En ocasiones, comparar los residuos entre diferentes modelos puede ayudar a diagnosticar problemas. Si los residuos de un modelo muestran menos patrones y están más cerca de cero, es posible que ese modelo se ajuste mejor a los datos.
Visualizando residuos
La visualización de residuos permite la representación gráfica de los errores entre los valores observados y predichos, lo que proporciona una comprensión intuitiva del rendimiento de un modelo de regresión. Al crear e interpretar gráficos de residuos, podemos identificar rápidamente cualquier desviación sistemática que sugiera problemas potenciales con el modelo.
La creación de gráficos de residuos suele ser uno de los primeros pasos en el proceso de análisis de residuos. Estos gráficos son fáciles de generar utilizando diversas herramientas de software estadístico y lenguajes de programación. Idealmente, un gráfico de este tipo debería mostrar residuos dispersos aleatoriamente alrededor del eje horizontal, lo que sugiere que el modelo de regresión se ajusta bien.
Al interpretar gráficos de residuos, buscamos la ausencia de patrones. Supongamos que los residuos muestran un patrón, especialmente una forma o tendencia discernible. En ese caso, esto es una señal de que el modelo de regresión no captura algún aspecto de la relación entre variables. Por ejemplo, un patrón en forma de U podría sugerir que un modelo no lineal es más apropiado. De manera similar, si los residuos aumentan o disminuyen con los valores predichos, podría indicar heterocedasticidad.
Consideraciones avanzadas
Dos problemas comunes que encuentran los analistas son la no linealidad y la heterocedasticidad en los datos. Comprender y abordar estos problemas es fundamental para mejorar la precisión y el poder predictivo del modelo.
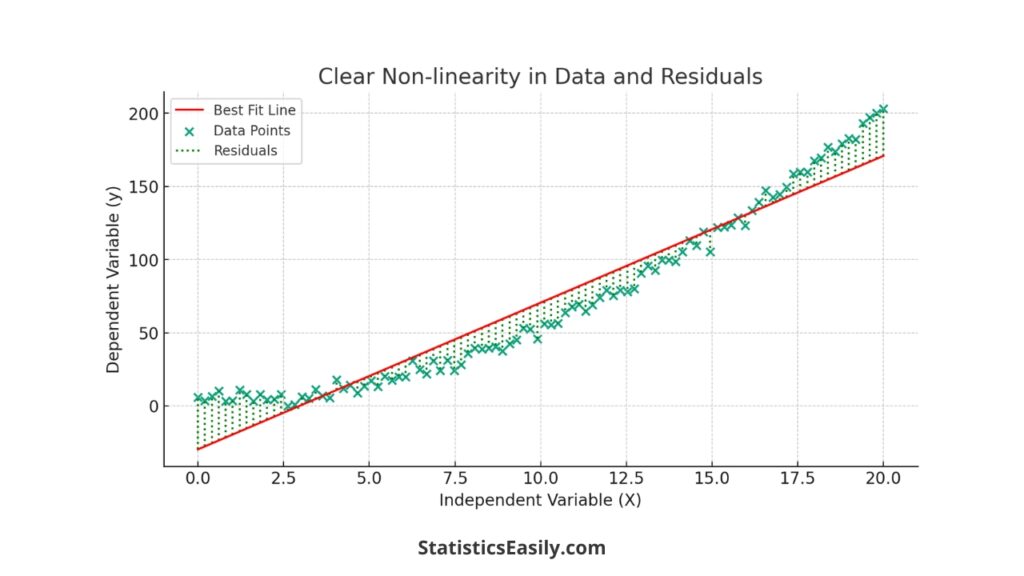
La no linealidad se produce cuando una línea recta no puede describir con precisión la relación entre las variables independientes y dependientes. Esto suele detectarse mediante un patrón sistemático en los residuos, como una forma curva o más compleja. Para abordar la no linealidad, puede ser necesaria la transformación de las variables. Por ejemplo, aplicar logaritmos o elevar al cuadrado las variables puede ayudar a linealizar la relación, lo que permite un mejor ajuste del modelo de regresión lineal.
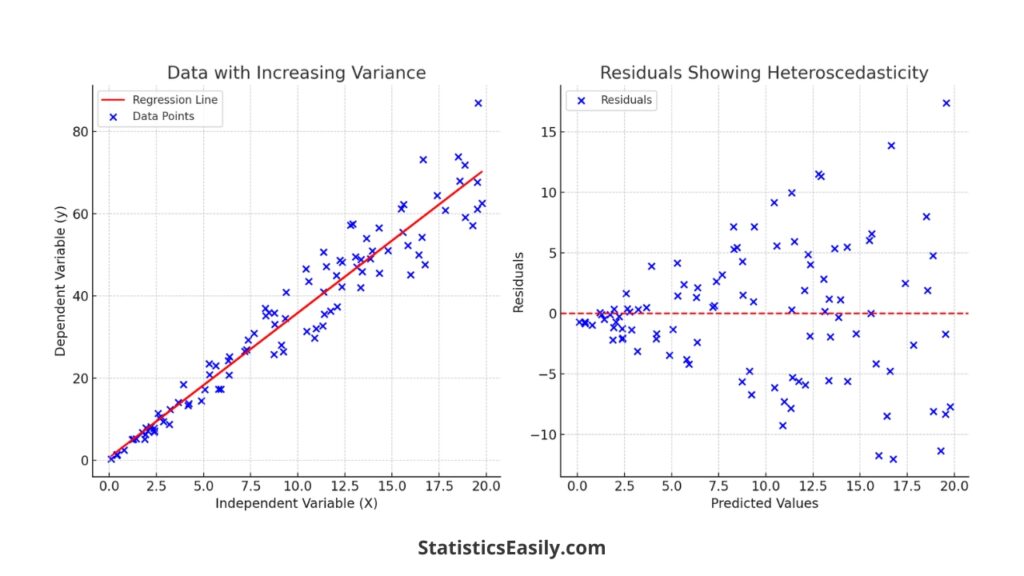
Por otro lado, la heterocedasticidad se presenta cuando los residuos no tienen varianza constante en todo el rango de valores predichos. Este problema suele identificarse mediante un patrón en forma de abanico o cono en el gráfico de residuos, donde la dispersión de los residuos aumenta con la magnitud del valor predicho. La heterocedasticidad puede ser problemática porque viola el supuesto de homocedasticidad de los residuos (varianza constante), que sustenta muchas de las pruebas estadísticas utilizadas en el análisis de regresión. Para abordar la heterocedasticidad, se podría considerar el uso de técnicas de regresión robusta o la transformación de la variable dependiente para estabilizar la varianza.
A continuación se ofrecen algunos consejos para mejorar el ajuste del modelo mediante el análisis residual:
1. Examine los gráficos de residuos: Analice cuidadosamente los gráficos de residuos en busca de patrones. Si se detectan patrones, considere utilizar regresión polinómica u otros modelos no lineales.
2. Transformación de variables: Aplique transformaciones logarítmicas, de raíz cuadrada o recíprocas a las variables dependientes o independientes para corregir la no linealidad o la heterocedasticidad.
3. Adición de variables: En ocasiones, incluir otra variable o un término de interacción puede ayudar a explicar los efectos que causan la no linealidad o la heterocedasticidad.
4. Modelos alternativos: Si los residuos indican que un modelo lineal no es apropiado, explore modelos no lineales que puedan proporcionar un mejor ajuste.
5. Mínimos cuadrados ponderados: Para datos heterocedásticos, la regresión de mínimos cuadrados ponderados puede ser útil al asignar ponderaciones a los puntos de datos en función de la varianza de sus residuos.
Conclusión
Los residuos, las discrepancias entre los valores observados y predichos, no son meros subproductos del modelado predictivo, sino que son parte integral de la evaluación de la precisión y idoneidad de un modelo de regresión. Arrojan luz sobre la capacidad del modelo para encapsular las tendencias de los datos subyacentes, asegurando así la validez de los conocimientos extraídos del análisis.
A lo largo de este artículo, hemos subrayado la vitalidad del cálculo de residuos, que revela la diferencia matizada entre los valores observados y predichos en los modelos de regresión. Hemos visto que el análisis residual práctico mejora la precisión de los modelos de regresión y ayuda a identificar patrones y deficiencias que podrían no ser evidentes en la superficie.
La interpretación precisa de los residuos es indispensable para diagnosticar el ajuste del modelo. Este artículo ha ilustrado que las técnicas avanzadas, como la transformación de variables y la adopción de métodos de regresión robustos, son herramientas necesarias en el arsenal del científico de datos para abordar la no linealidad y la heterocedasticidad, desafíos comunes en los datos del mundo real.
Título del anuncio
Descripción del anuncio. Lorem ipsum dolor sit amet, consectetur adipiscing elit.
Artículos recomendados
Descubra más conocimientos y técnicas avanzadas en análisis de regresión explorando nuestra colección completa de artículos relacionados en nuestro blog.
- ¿Qué es el análisis de regresión? Una guía completa para principiantes
- Cómo informar resultados de regresión lineal simple en estilo APA
- Supuestos en regresión lineal: una guía completa
Preguntas Frecuentes (FAQ)
P1: ¿Qué son los residuos en el análisis de regresión?Los residuos son las diferencias entre los valores observados y predichos en un modelo de regresión, cruciales para evaluar la precisión del modelo.
P2: ¿Por qué son cruciales los residuos en los modelos de regresión?Ayudan a identificar qué tan bien se ajusta el modelo a los datos y a resaltar áreas de mejora.
P3: ¿Cómo se calculan los residuos en una regresión?Reste el valor predicho del valor observado real para cada punto de datos en su conjunto de datos.
P4: ¿Qué pueden indicar los patrones en los residuos?Los patrones en los residuos pueden revelar problemas como la no linealidad, la heterocedasticidad u otras imprecisiones del modelo.
P5: ¿Cómo mejoran los residuos la precisión del modelo?El análisis de los residuos puede conducir al perfeccionamiento del modelo, lo que garantiza predicciones y análisis más precisos.
P6: ¿Cuál es la finalidad de un gráfico de residuos?Un gráfico de residuos evalúa visualmente la distribución de los residuos frente a los valores predichos, lo que ayuda a identificar cualquier error sistemático.
P7: ¿Pueden los residuos indicar sobreajuste?Sí, unos residuos inusualmente grandes pueden sugerir sobreajuste, donde el modelo captura ruido en lugar de patrones subyacentes.
P8: ¿Cómo se identifican los valores atípicos utilizando los residuos?Los residuos grandes y significativos suelen revelar valores atípicos, que difieren notablemente de otros puntos de datos.
P9: ¿Qué significa la heterocedasticidad en los residuos?La heterocedasticidad se produce cuando los residuos muestran una variabilidad no constante, lo que indica posibles problemas en los supuestos del modelo.
P10: ¿Cómo se puede abordar la no linealidad en los residuos?Abordar la no linealidad podría implicar transformar variables o adoptar modelos no lineales más complejos.