Bosque aleatorio en la práctica: una guía esencial
Aprenderá cómo Random Forest aprovecha los árboles de decisión para mejorar la precisión predictiva en conjuntos de datos complejos.
Introducción
Bosque al azares un algoritmo esencial de aprendizaje automático que ha ganado gran popularidad en la ciencia de datos gracias a su eficacia en tareas de clasificación y regresión. Su éxito radica en la capacidad de construir múltiples árboles de decisión durante el entrenamiento y generar la moda de las clases (clasificación) o la predicción media (regresión) de cada árbol. Esta guía introductoria está diseñada para desmitificar Random Forest para principiantes, proporcionando una explicación clara y paso a paso de su funcionamiento, junto con una guía práctica para su implementación en Python. Nuestro objetivo es brindar a los lectores el conocimiento necesario para comprender los fundamentos teóricos de Random Forest y aplicarlo eficazmente en sus proyectos de ciencia de datos, aprovechando las potentes capacidades de programación de Python.
Destacados
- Random Forest supera a los árboles de decisión única al reducir el sobreajuste.
- El ajuste de hiperparámetros en Random Forest mejora de manera crucial la precisión del modelo.
- El preprocesamiento de datos es fundamental para el éxito predictivo de Random Forest.
- La guía paso a paso de Python simplifica la implementación de Random Forest.
- La evaluación de modelos de Random Forest implica métricas de exactitud, precisión y recuperación.
Título del anuncio
Descripción del anuncio. Lorem ipsum dolor sit amet, consectetur adipiscing elit.
Entendiendo Random Forest
Bosque al azares un algoritmo de aprendizaje automático que se basa en el concepto de árboles de decisión para proporcionar un modelo predictivo más preciso y robusto. Crea numerosos árboles de decisión durante el entrenamiento. El resultado es la clase, es decir, la moda de las clases (en clasificación) o la predicción media (en regresión) de cada árbol individual.
Cómo funciona el bosque aleatorio:
Árboles de decisión: Random Forest parte de árboles de decisión, que son modelos de toma de decisiones sencillos con estructura de árbol. Cada árbol en Random Forest ofrece una predicción, y el algoritmo toma la votación mayoritaria o el promedio, en el caso de la regresión, como resultado final.
Bootstrapping: Esta técnica selecciona aleatoriamente un subconjunto del conjunto de datos para cada árbol, lo que garantiza la diversidad entre los árboles y contribuye a la robustez del modelo.
Agregación (Bagging): El algoritmo agrega las predicciones de los árboles individuales para producir una predicción más precisa y estable.
Ventajas del bosque aleatorio:
Menor sobreajuste: A diferencia de los árboles de decisión individuales, que suelen sufrir sobreajuste a sus datos de entrenamiento, Random Forest mitiga este riesgo mediante su enfoque de conjunto. El promedio de las predicciones de numerosos árboles garantiza que la predicción general del modelo no dependa excesivamente de ninguna parte específica de los datos de entrenamiento, lo que da lugar a resultados más generalizables.
Alta precisión: La fortaleza de Random Forest reside en la agregación de predicciones de múltiples árboles de decisión, cada uno entrenado con diferentes subconjuntos de los mismos datos. Este método de conjunto aumenta significativamente la precisión de la predicción, superando a muchos enfoques de modelo único en diversos conjuntos de datos y tipos de problemas.
Versatilidad en la aplicación: El diseño de Random Forest le permite destacar en diversas tareas, desde la predicción de resultados categóricos en problemas de clasificación hasta la estimación de variables continuas en análisis de regresión. Su manejo robusto de conjuntos de datos con valores faltantes y su capacidad para procesar datos numéricos y categóricos sin un preprocesamiento extenso lo hacen excepcionalmente flexible.
Información sobre la importancia de las características: Una de las capacidades más destacadas de Random Forest es su mecanismo inherente de selección de características. Al analizar el impacto de cada característica en la precisión de la predicción en todos los árboles, Random Forest puede clasificar la importancia de las características dentro del conjunto de datos. Esta información es invaluable para comprender los factores que influyen en las predicciones y puede guiar la selección de características en los procesos de refinamiento del modelo y análisis de los datos procesos.
Aplicaciones de Random Forest:
Finanzas: El algoritmo Random Forest se utiliza ampliamente en el sector financiero para tareas críticas como la evaluación del riesgo crediticio mediante el análisis de las calificaciones crediticias y la previsión de movimientos futuros en el mercado de valores, lo que ayuda a las estrategias de inversión.
Comercio electrónico: Este algoritmo optimiza la experiencia de compra en línea mediante sistemas de recomendación que sugieren productos según el comportamiento y las preferencias del usuario. Además, desempeña un papel fundamental en la segmentación de clientes en grupos diferenciados para estrategias de marketing y promoción específicas.
Cuidado de la salud: En el ámbito médico, el algoritmo Random Forest contribuye a la detección temprana de enfermedades mediante el análisis de datos de pacientes que indican síntomas de afecciones específicas. Además, ayuda a clasificar a los pacientes en grupos de riesgo, facilitando así planes de tratamiento personalizados.
Ciberseguridad: Dada la creciente sofisticación de las ciberamenazas, Random Forest ayuda a detectar y predecir de forma oportuna posibles fraudes e infracciones de seguridad, aprovechando la detección de anomalías en los patrones de datos para salvaguardar los activos digitales.
Fundamentos teóricos del bosque aleatorio
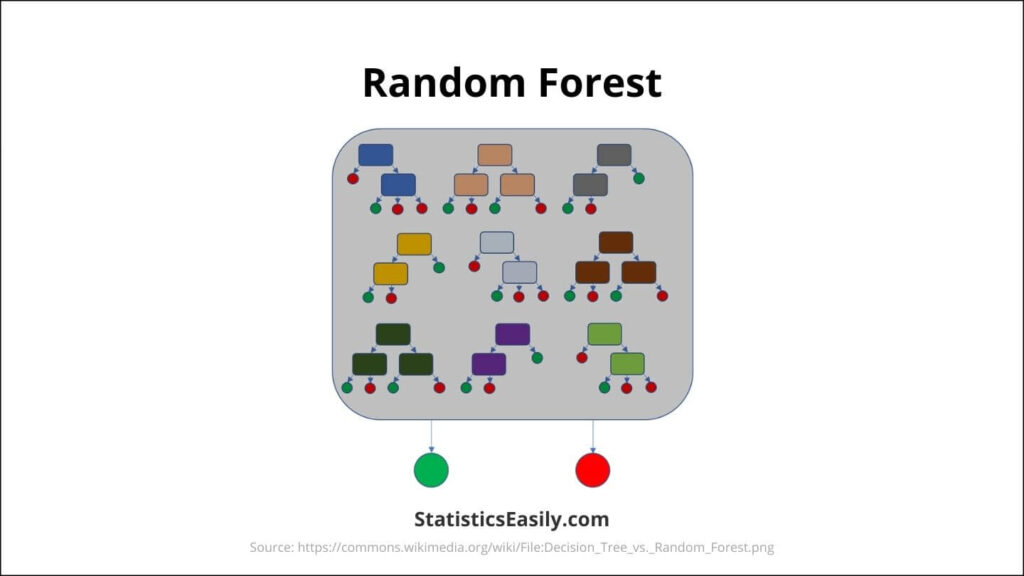
Bosque al azarfunciona según el principio de aprendizaje conjunto, donde se combinan múltiples clasificadores, en este caso árboles de decisión, para resolver un problema complejo y mejorar el rendimiento del modelo.
Explicación detallada del algoritmo:
Conjunto de árboles de decisión: Random Forest crea un conjunto de árboles de decisión no correlacionados, cada uno entrenado con subconjuntos aleatorios de los datos de entrenamiento, utilizando una técnica de remuestreo (bootstrapping).
Selección aleatoria de características: Cada árbol elige un subconjunto aleatorio de características en cada división. Esta aleatoriedad ayuda a que los árboles sean más diversos, lo que aumenta la precisión general del modelo.
Agregación: La predicción final del Bosque Aleatorio se determina mediante la agregación de las predicciones de los árboles individuales. Esta agregación reduce la varianza, controla el sobreajuste y mejora la precisión predictiva del modelo.
Hiperparámetros y su impacto:
Número de árboles (n_estimators): Aumentar el número de árboles generalmente mejora el rendimiento del modelo, pero aumenta el coste computacional.
Profundidad máxima (max_depth): Controla la profundidad de cada árbol. Los árboles más profundos pueden capturar patrones más complejos, pero pueden provocar sobreajuste.
División de muestras mínimas (min_samples_split): Determina el número mínimo de muestras necesarias para dividir un nodo interno. Valores más altos impiden que el modelo aprenda patrones demasiado específicos.
Características máximas (max_features): El tamaño de los subconjuntos aleatorios de características que se consideran al dividir un nodo. Influye en la diversidad de árboles en el bosque.
Medición de la eficacia:
Exactitud: La proporción de observaciones predichas correctamente con respecto al total de observaciones. Es una métrica valiosa para problemas de clasificación equilibrada.
Matriz de confusión: Un desglose detallado del rendimiento del modelo, incluyendo verdaderos positivos, verdaderos negativos, falsos positivos y falsos negativos.
Precisión, Exhaustividad y Puntuación F1: La precisión es la proporción de observaciones positivas predichas correctamente con respecto al total de observaciones positivas predichas. La exhaustividad (sensibilidad) mide la proporción de observaciones positivas predichas correctamente con respecto al total de observaciones en la clase real. La puntuación F1 es el promedio ponderado de la precisión y la exhaustividad. Estas métricas son fundamentales en el contexto de conjuntos de datos desequilibrados.
Preparando sus datos
El preprocesamiento de datos eficaz es un paso crucial en el aprendizaje automático que afecta significativamente el rendimiento de modelos como Random Forest. Esta sección describe los pasos esenciales de limpieza y preparación de datos, asegurando que los datos estén estructurados de manera óptima para el modelado de Random Forests.
Importancia del preprocesamiento de datos:
El preprocesamiento de datos transforma los datos sin procesar en un conjunto de datos limpio que se puede utilizar directamente para modelos de aprendizaje automático. Este proceso es vital porque influye directamente en la capacidad del modelo para aprender y hacer predicciones precisas. Para Random Forest, donde intervienen múltiples árboles de decisión, el preprocesamiento garantiza coherencia y calidad en todo el conjunto de datos, lo que permite que el algoritmo identifique patrones de manera más efectiva.
Pasos para la limpieza y preparación de datos:
1. Manejo de valores faltantes: El algoritmo Random Forest puede manejar valores faltantes hasta cierto punto. Sin embargo, generalmente se recomienda imputar los valores faltantes utilizando estrategias como la imputación por la media para características numéricas y la imputación por la moda para características categóricas.
2. Codificación de variables categóricas: Convierta las variables categóricas a formato numérico mediante técnicas de codificación como la codificación one-hot o la codificación de etiquetas, ya que Random Forest no puede procesar datos textuales sin procesar.
3. Escalado de características: Si bien Random Forest no es tan sensible al escalado de características como algoritmos como SVM o KNN, garantizar que todas las características estén en la misma escala puede ayudar a mejorar la convergencia del modelo y la interpretabilidad de las puntuaciones de importancia de las características.
4. Eliminación de características irrelevantes: Elimine las características que no contribuyen a la predicción o que podrían introducir ruido. Si bien Random Forest selecciona características al azar durante el entrenamiento, reducir la dimensionalidad de antemano puede disminuir el tiempo y la complejidad del entrenamiento.
Dividiendo el conjunto de datos:
Conjuntos de entrenamiento y prueba: Divide tus datos en conjuntos de entrenamiento y prueba para evaluar el rendimiento del modelo con datos no vistos. Una proporción típica de división es 70:30 u 80:20, donde la porción más significativa se utiliza para el entrenamiento.
Validación cruzada: Considere la posibilidad de utilizar técnicas de validación cruzada, especialmente la validación cruzada k-fold, para garantizar que el rendimiento del modelo sea consistente en diferentes subconjuntos de datos.
Aplicación práctica de bosque aleatorio con Python
Aplicar Random Forest enPythoncombina eficazmente la comprensión teórica del algoritmo con habilidades prácticas de programación. Esta sección te guía en la configuración de tu entorno Python, la implementación de Random Forest con la bibliotecasklearny su aplicación a un conjunto de datos real.
Un ejemplo práctico: predecir las especies de iris
El conjunto de datos de Iris contiene 150 plantas de iris, clasificadas en tres especies según cuatro características: longitud del sépalo, ancho del sépalo, longitud del pétalo y ancho del pétalo. El modelo Random Forest aprende de los datos de entrenamiento y predice con precisión las especies de plantas de iris.
Siguiendo los pasos a continuación, puede implementar bosques aleatorios en Python para varios conjuntos de datos, no solo para el conjunto de datos Iris. Ajuste los hiperparámetros del modelo, como n_estimators y max_ Depth, para mejorar el rendimiento en función de su conjunto de datos y tarea específicos.
Los fragmentos de código proporcionados están diseñados para que sean sencillos de seguir, con explicaciones para cada paso para facilitar la comprensión y la implementación. Esta aplicación práctica demuestra el poder de los bosques aleatorios en el modelado predictivo. Proporciona una base sólida para explorar proyectos de ciencia de datos más complejos.
Configurando su entorno Python
Para trabajar con Random Forest en Python, asegúrese de tener Python instalado en su máquina. Utilice los siguientes paquetes:
- NumPy: Para manejar matrices y arreglos.
- pandas: Para manipulación y análisis de datos.
- Aprendizaje de ciencias (sklearn): proporciona el algoritmo Random Forest y funcionalidad adicional para crear modelos predictivos.
- Matplotlib/Seaborn: Para visualizar datos y resultados del modelo.
Instale estos paquetes usando pip:
pip install numpy pandas scikit-learn matplotlib seaborn
Implementando Random Forest con sklearn
El módulo sklearn.ensemble incluye RandomForestClassifier para tareas de clasificación y RandomForestRegressor para tareas de regresión. Aquí hay una guía paso a paso para usar RandomForestClassifier:
1. Importar bibliotecas necesarias:
from sklearn.ensemble import RandomForestClassifier
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score, confusion_matrix, classification_report
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns
2. Carga tu conjunto de datos:Para este ejemplo, utilizaremos el conjunto de datos Iris, un clásico en los ejemplos de aprendizaje automático.
from sklearn.datasets import load_iris
iris = load_iris()
X = iris.data
y = iris.target
3. Divide el conjunto de datos:Divide tus datos en conjuntos de entrenamiento y prueba para evaluar el rendimiento del modelo.
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
4. Inicializar y entrenar el modelo:Crea una instancia de RandomForestClassifier y ajústala a tus datos de entrenamiento.
clf = RandomForestClassifier(n_estimators=100, random_state=42)
clf.fit(X_train, y_train)
5. Realizar predicciones y evaluar el modelo:Utilizar el modelo entrenado para predecir el conjunto de prueba y evaluar su precisión.
y_pred = clf.predict(X_test)
print(f"Accuracy: {accuracy_score(y_test, y_pred)}")
Resultados e interpretación del modelo
Después de entrenar el modelo y hacer predicciones, es fundamental interpretar los resultados para comprender su rendimiento y cómo se puede mejorar.
Evaluación del rendimiento del modelo:En primer lugar, examine la precisión del modelo y, a continuación, explore métricas más descriptivas.
# Model Accuracy
print(f"Model Accuracy: {accuracy_score(y_test, y_pred):.2f}")
Matriz de confusión:Una matriz de confusión proporciona información sobre las predicciones correctas e incorrectas de cada clase.
cm = confusion_matrix(y_test, y_pred)
sns.heatmap(cm, annot=True, fmt="d", cmap="viridis", xticklabels=iris.target_names, yticklabels=iris.target_names)
plt.xlabel('Predicted')
plt.ylabel('Actual')
plt.title('Confusion Matrix')
plt.show()
Informe de clasificación:El informe de clasificación incluye métricas como precisión, exhaustividad y puntuación F1 para cada clase.
print(classification_report(y_test, y_pred, target_names=iris.target_names))
Importancia de las características:comprender qué características influyen de forma más significativa en las decisiones de su modelo puede proporcionar información valiosa sobre el conjunto de datos.
feature_importance = clf.feature_importances_
sns.barplot(x=feature_importance, y=iris.feature_names)
plt.title('Feature Importance')
plt.show()
Interpretación del modelo
La puntuación de precisión, la matriz de confusión y el informe de clasificación ofrecen en conjunto una visión completa del rendimiento del modelo. La alta precisión indica la efectividad del modelo en la clasificación de especies de iris, mientras que la matriz de confusión y el informe de clasificación detallan su precisión, recuperación y puntuaciones f1 en todas las clases.
El gráfico de importancia de las características revela qué características de las flores del iris (como la longitud o el ancho de los pétalos) influyen en las decisiones de clasificación del modelo. Esta información es valiosa para comprender el proceso de toma de decisiones del modelo Random Forest y los futuros esfuerzos de selección o ingeniería de características.
Al interpretar estos resultados, podemos concluir que el clasificador Random Forest es muy eficaz para este conjunto de datos y proporciona una base sólida para las tareas de modelado predictivo. Experimentar con diferentes conjuntos de datos o ajustar hiperparámetros podría mejorar el rendimiento o la adaptabilidad del modelo a diversos problemas.
Interpretación de árboles de decisión individuales dentro de Random Forest
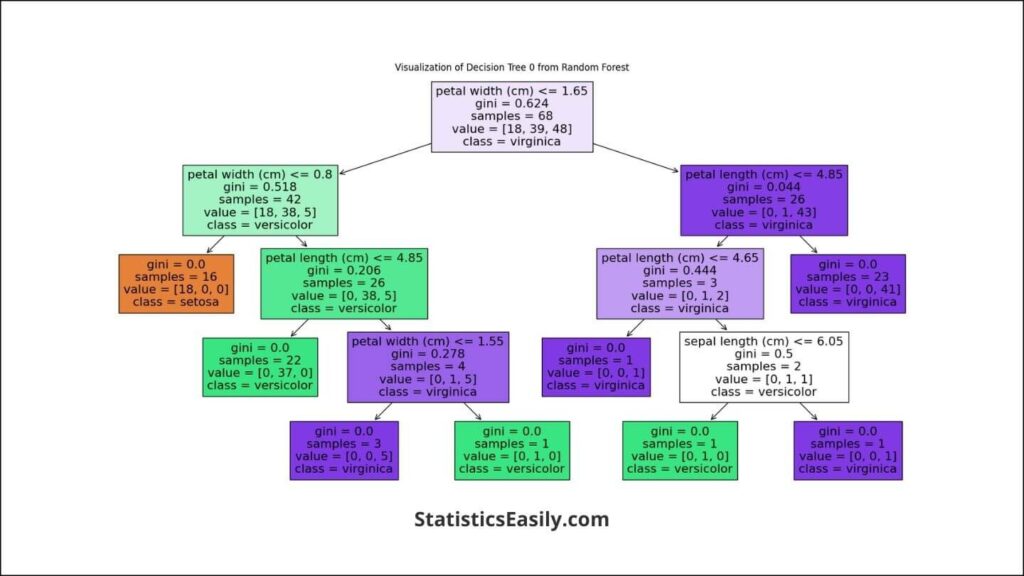
Si bien Random Forest es una colección de árboles de decisión, cada árbol contribuye al resultado. La visualización de árboles individuales puede proporcionar información sobre el proceso de toma de decisiones en un nivel más granular. Examinemos uno de esos árboles de nuestro modelo de bosque aleatorio:
Visualizando un árbol de decisión del bosque aleatorio:
# Visualize the first decision tree from the Random Forest
tree_index = 0
plt.figure(figsize=(20,10))
plot_tree(clf.estimators_[tree_index],
          feature_names=iris.feature_names,
          class_names=iris.target_names,
          filled=True,
          rounded=True)
plt.title(f'Decision Tree Visualization: Tree {tree_index}')
plt.show()
Esta visualización muestra cómo un único árbol de decisión dentro de Random Forest realiza clasificaciones. Comienza en la parte superior con un nodo raíz, luego se divide en ramas y nodos de decisión según los valores de las características y finalmente termina con nodos hoja que representan las predicciones de clase.
Analizando la estructura del árbol:
Cada nodo del árbol representa una decisión basada en el valor de una característica particular. Por ejemplo, un nodo podría dividir los datos según la longitud o el ancho del pétalo de una flor de iris. Las ramas representan el resultado de esa decisión y conducen a nuevos nodos de decisión o nodos hoja. Los nodos hoja proporcionan las predicciones de clase finales cuando se cumple un conjunto de criterios determinados por la ruta desde la raíz.
La profundidad y complejidad de este árbol indican la estrategia de clasificación del modelo. En la práctica, Random Forest combina las predicciones de varios de estos árboles para realizar una clasificación final más precisa, aprovechando así las fortalezas de cada árbol y compensando sus debilidades.
Incluir una visualización de árbol de decisiones como la generada anteriormente puede enriquecer su artículo al permitir a los lectores visualizar el proceso predictivo. Desmitifica el funcionamiento del modelo y proporciona un ejemplo tangible de cómo Random Forest aprovecha múltiples rutas de decisión para llegar a una decisión de clasificación.
Evaluación de su modelo
Después de implementar el modelo Random Forest usando Python, el siguiente paso crucial es evaluar su desempeño. Esto implica el uso de métricas específicas para comprender qué tan bien el modelo predice los resultados de datos nuevos e invisibles. Esta sección cubre las métricas de evaluación críticas y ofrece sugerencias de mejora y ajuste del modelo.
Cómo evaluar el rendimiento de su modelo de bosque aleatorio:
Las métricas de evaluación son esenciales para evaluar la precisión y eficacia de su modelo de Random Forest. Estas son las métricas más utilizadas:
Exactitud: Esta es la métrica más sencilla, calculada dividiendo el número de predicciones correctas entre el número total de predicciones. Si bien es útil, la precisión por sí sola puede ser engañosa, especialmente en conjuntos de datos con clases desequilibradas.
Precisión y recuperación: La precisión (la proporción de resultados positivos verdaderos en todas las predicciones positivas) y la exhaustividad (la proporción de resultados positivos verdaderos en todos los positivos reales) son fundamentales cuando los costos de los falsos positivos y los falsos negativos son altos, por ejemplo, en escenarios de diagnóstico médico o detección de fraude.
F1 Score: La puntuación F1 es la media armónica de la precisión y la exhaustividad, y proporciona una métrica única para evaluar su equilibrio. Una puntuación F1 alcanza su valor óptimo en 1 (precisión y exhaustividad perfectas) y su valor máximo en 0.
Matriz de confusión: Tabla utilizada para describir el rendimiento de un modelo de clasificación en un conjunto de datos de prueba cuyos valores reales se conocen. Permite visualizar las predicciones del modelo, incluyendo verdaderos positivos, falsos positivos, verdaderos negativos y falsos negativos.
Interpretación de los resultados:
Comprender estas métricas le permite medir el rendimiento del modelo con precisión. Por ejemplo, una tasa de precisión alta puede parecer excelente a primera vista. Sin embargo, una inspección más detallada a través de la precisión, la recuperación y la puntuación F1 podría revelar áreas en las que el modelo tiene problemas, como no predecir con precisión una clase en particular.
Consejos para mejorar y ajustar el modelo:
Ajuste de hiperparámetros: Los modelos de Bosque Aleatorio cuentan con varios hiperparámetros, como el número de árboles (n_estimators) y la profundidad de los árboles (max_depth), que pueden afectar significativamente su rendimiento. El uso de métodos de búsqueda en cuadrícula o búsqueda aleatoria puede ayudar a encontrar la combinación óptima de estos hiperparámetros para su conjunto de datos específico.
Selección de características: Los bosques aleatorios pueden clasificar inherentemente la importancia de las características. Al analizar y eliminar las características menos importantes, se puede reducir la complejidad del modelo y mejorar su rendimiento.
Validación cruzada: La implementación de la validación cruzada, como la validación cruzada k-fold, ayuda a garantizar que el rendimiento de su modelo sea consistente en diferentes subconjuntos de su conjunto de datos, lo que aumenta la robustez de su modelo.
Título del anuncio
Descripción del anuncio. Lorem ipsum dolor sit amet, consectetur adipiscing elit.
Conclusión
Este artículo proporciona una guía completa para comprender y aplicar Random Forest en Python, que cubre sus fundamentos teóricos, preparación de datos, implementación práctica y evaluación de modelos. Con su capacidad para manejar tareas de clasificación y regresión de manera efectiva, Random Forest sigue siendo una herramienta poderosa en el arsenal de los científicos de datos, ya que ofrece alta precisión y solidez contra el sobreajuste. El estímulo para experimentar con diferentes conjuntos de datos y enfrentar diversos problemas de modelado predictivo subraya la versatilidad y adaptabilidad de Random Forest. Al seguir los pasos detallados, desde la configuración del entorno Python hasta la evaluación del rendimiento del modelo, los lectores estarán bien equipados para aprovechar Random Forest en sus proyectos de ciencia de datos, ampliando los límites del análisis predictivo.
Artículos recomendados
Explore más ideas y tutoriales sobre temas de ciencia de datos consultando nuestros otros artículos.
- Árboles de decisión: de la teoría a la práctica en Python para aspirantes a científicos de datos
- Comprensión del muestreo aleatorio: técnicas esenciales en el análisis de datos
- Muestreo aleatorio en Excel: un análisis en profundidad
- Regresión logística utilizando Scikit-Learn (Historia)
- Generar un número aleatorio
Preguntas Frecuentes (FAQ)
P1: ¿Qué es Random Forest?Es un método versátil de aprendizaje automático capaz de realizar tareas de regresión y clasificación, utilizando múltiples árboles de decisión y promediando sus predicciones para mejorar la precisión y controlar el sobreajuste.
P2: ¿Cómo funciona un Bosque Aleatorio?Un Bosque Aleatorio crea un "bosque" de árboles de decisión aleatorios para hacer que sus predicciones sean más precisas que las de cualquier árbol de decisión individual, promediando los resultados o utilizando la votación por mayoría.
P3: ¿Por qué se prefiere Random Forest a otros algoritmos?Se prefiere debido a su versatilidad, su capacidad para manejar grandes conjuntos de datos con mayor dimensionalidad y su capacidad para gestionar valores faltantes, lo que lo hace resistente al sobreajuste.
P4: ¿Cuáles son las principales aplicaciones de Random Forest?Se utiliza ampliamente en diversos campos, como la banca, la medicina, el mercado de valores y el comercio electrónico, para la detección de fraudes, la predicción de enfermedades, la predicción del precio de las acciones y la segmentación de clientes.
P5: ¿Cómo se preparan los datos para Random Forest?La preparación de datos implica la limpieza, el manejo de valores faltantes, la codificación de variables categóricas y la división del conjunto de datos en conjuntos de entrenamiento y prueba.
P6: ¿Qué son los hiperparámetros en Random Forest y cómo afectan al modelo?Los hiperparámetros influyen en la complejidad y el rendimiento del modelo, como el número de árboles, la profundidad de los árboles y la división mínima de muestras. Ajustarlos puede mejorar significativamente la precisión.
P7: ¿Cómo se puede evaluar la efectividad de un modelo de Bosque Aleatorio?Las métricas de evaluación estándar incluyen precisión, exactitud, exhaustividad, puntuación F1 y la matriz de confusión, que ayudan a evaluar el rendimiento predictivo y la precisión del modelo.
P8: ¿Cuáles son algunos de los desafíos al usar bosques aleatorios?Si bien son potentes, los bosques aleatorios pueden requerir mucha capacidad de cálculo y ser difíciles de interpretar en comparación con modelos más simples, y su rendimiento puede ser sensible a los datos ruidosos.
P9: ¿Cómo se optimiza un modelo de Bosque Aleatorio para obtener un mejor rendimiento?La optimización del modelo implica ajustar hiperparámetros como el número de árboles, la profundidad máxima y la división mínima de muestras mediante técnicas de búsqueda en cuadrícula o aleatoria para encontrar la configuración más óptima.
P10: ¿Puede Random Forest manejar datos tanto categóricos como numéricos?Sí, Random Forest puede manejar una combinación de datos categóricos y numéricos. Utiliza técnicas como la codificación one-hot para variables categóricas, lo que permite que los datos sean adecuados para el modelado.