Árboles de decisión: de la teoría a la práctica en Python para aspirantes a científicos de datos
Aprenderá los principios fundamentales de los árboles de decisión y su aplicación práctica en Python para obtener información basada en datos.
Introducción
Árboles de decisiónson fundamentales en análisis de los datos, la ciencia de datos y el aprendizaje automático, ya que ofrecen un marco que simplifica los procesos complejos de toma de decisiones gracias a su estructura intuitiva. Estos modelos dividen los datos en segmentos comprensibles, lo que permite tanto a expertos como a principiantes descubrir patrones y obtener información valiosa con claridad. La elegancia deÁrboles de decisiónreside en su capacidad para transformar conjuntos de datos complejos en información visualmente comprensible y organizada lógicamente, facilitando así la toma de decisiones y la formulación de predicciones fundamentadas. Esta introducción sentará las bases para el uso deÁrboles de decisiónen Python, guiando a los aspirantes a científicos de datos desde la comprensión teórica hasta la aplicación práctica.
Destacados
- Los árboles de decisión clasifican datos con una simplicidad y precisión incomparables.
- scikit-learn de Python simplifica la implementación de árboles de decisión.
- Los árboles de decisión iluminan datos complejos y ofrecen caminos claros para la toma de decisiones.
- Las técnicas de optimización mejoran la precisión de los árboles de decisión sin sobreajustarlos.
- La visualización de árboles de decisión en Python desmitifica los procesos de análisis de datos.
Título del anuncio
Descripción del anuncio. Lorem ipsum dolor sit amet, consectetur adipiscing elit.
Comprensión de los árboles de decisión
Árboles de decisiónson un método de análisis de datos que presenta una estructura jerárquica de las decisiones y sus posibles consecuencias, incluyendo resultados aleatorios, costos de recursos y utilidad. Este método resulta atractivo en la ciencia de datos por su claridad en la toma de decisiones y su interpretabilidad.
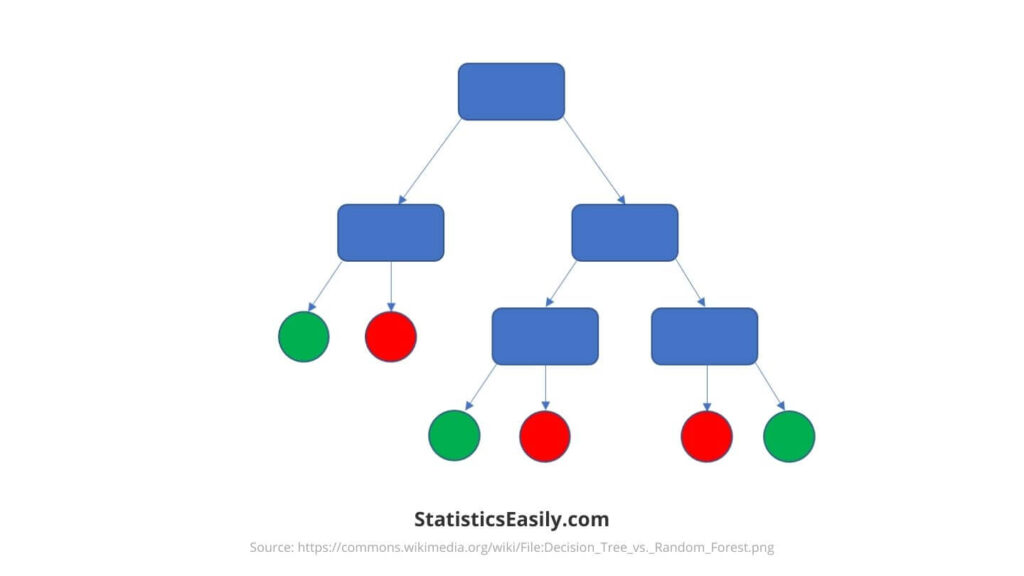
En esencia,Árboles de decisióndividen los datos en ramas según criterios de decisión basados en las características del conjunto de datos. Estas divisiones se realizan en los nodos, siendo el primer nodo la raíz del árbol. Cada nodo representa un punto de decisión, y las ramas representan el resultado de esa decisión, lo que da lugar a divisiones adicionales hasta que los nodos hoja representan los resultados o predicciones.
La creación de unÁrbol de decisiónimplica determinar la mejor característica para realizar la división en cada paso. Esta decisión se basa en medidas como la impureza de Gini o la entropía en tareas de clasificación, y la reducción de la varianza en regresión. Estos criterios ayudan a elegir las divisiones que purifican de forma más eficaz los nodos hijos.
La profundidad de unÁrbol de decisiónmide la ruta más larga desde la raíz hasta una hoja. Un árbol más profundo podría modelar los datos de entrenamiento con mayor precisión, pero también conlleva el riesgo de sobreajuste, donde el modelo funciona bien con los datos de entrenamiento, pero mal con los datos no vistos. Por el contrario, un árbol poco profundo podría ser demasiado simple para capturar la estructura subyacente de los datos, lo que provocaría un subajuste.
Árboles de decisiónson muy apreciados por su capacidad para modelar procesos de decisión complejos mediante una combinación de simplicidad y robustez. Pueden manejar datos tanto numéricos como categóricos, lo que los hace versátiles para una amplia gama de aplicaciones. Además, su estructura permite una fácil visualización e interpretación, convirtiéndolos en una herramienta accesible para que los científicos de datos comuniquen sus hallazgos.
La base teórica deÁrboles de decisiónenfatiza la ejecución técnica y la presentación clara de decisiones basadas en datos. Esto se alinea con la búsqueda de la verdad y la comprensión en la ciencia de datos, ilustrando cómo se pueden analizar los datos para revelar información valiosa que guíe decisiones prácticas e informadas. Mediante este método, los científicos de datos pueden navegar por la complejidad de sus conjuntos de datos, descubrir patrones y predecir resultados con un equilibrio entre precisión y simplicidad.
La importancia de los árboles de decisión en el análisis de datos
La aplicación deÁrboles de decisiónse extiende mucho más allá de un solo ámbito, demostrando una versatilidad sin precedentes en diversos campos, como el análisis empresarial, la atención médica, las finanzas y otros. En la toma de decisiones empresariales, por ejemplo, evalúan los resultados potenciales de las decisiones estratégicas, la evaluación de riesgos y la segmentación de clientes. Los profesionales de la salud utilizanÁrboles de decisiónpara la predicción de diagnósticos, la evaluación de riesgos de los pacientes y el análisis de la eficacia de los tratamientos, ofreciendo una guía para la medicina personalizada y una mejor atención al paciente.
Una ventaja crucial deÁrboles de decisiónes su interpretabilidad. A diferencia de muchos modelos complejos que funcionan como «cajas negras»,Árboles de decisiónvisualizan el proceso de toma de decisiones, lo que permite a los usuarios comprender cómo se llega a las conclusiones. Esta transparencia es invaluable en campos donde comprender el razonamiento detrás de una predicción es tan importante como la predicción misma, como la atención médica y las finanzas.
Además, cabe destacar la facilidad de uso deÁrboles de decisión. No requieren una preparación exhaustiva de los datos; pueden manejarse directamente tanto con datos categóricos como numéricos, y las relaciones no lineales entre los parámetros no afectan su rendimiento. Esta facilidad de uso garantiza queÁrboles de decisiónsean accesibles a un público amplio, incluso a personas con conocimientos limitados de estadística o programación.
La principal ventaja deÁrboles de decisiónen el ámbito analítico reside en su capacidad para equilibrar la simplicidad con una gran capacidad predictiva. Se pueden aplicar a problemas de regresión y clasificación, lo que los convierte en una herramienta versátil para el científico de datos. Además, su estructura facilita la aplicación de técnicas como la poda, que ayuda a evitar el sobreajuste y garantiza la robustez y fiabilidad del modelo.
Preparar sus datos para un modelo de árboles de decisión
La preparación de datos es una etapa crucial en el modelado, sobre todo al trabajar conÁrboles de decisión. Esta sección profundiza en los pasos esenciales para preparar su conjunto de datos: limpiarlo y dividirlo en conjuntos de entrenamiento y prueba. Cada paso garantiza la integridad de su modelo y refleja la rigurosa búsqueda de la verdad en la ciencia de datos.
La limpieza de datosimplica identificar y corregir errores o inconsistencias en el conjunto de datos. Esto puede incluir el tratamiento de valores faltantes, la eliminación de duplicados o la corrección de errores de entrada de datos. ParaÁrboles de decisión, es fundamental garantizar que los datos estén libres de imprecisiones, ya que estos modelos interpretan directamente la estructura y el contenido de los datos. Los datos limpios constituyen la base sobre la que se construyen modelos fiables e interpretables.
Dividir los datosen conjuntos de entrenamiento y prueba es un paso fundamental para evaluar la eficacia del modeloÁrbol de decisión. Generalmente, los datos se dividen aleatoriamente, con una distribución estándar del 70 % para entrenamiento y el 30 % para prueba. El conjunto de entrenamiento se utiliza para construir el modelo, mientras que el conjunto de prueba evalúa su rendimiento con datos nuevos. Este paso es crucial para evaluar la capacidad de generalización del modelo, asegurando que pueda realizar predicciones precisas con datos nuevos y desconocidos. Es la esencia de crear modelos que reflejen la realidad y en los que se pueda confiar para tomar decisiones.
Construyendo sus primeros árboles de decisión en Python
Construir unÁrbol de decisiónen Python simplifica el proceso de análisis de datos y aprendizaje automático, haciéndolo accesible incluso para principiantes. Esta sección te guía en la creación de tu primerÁrbol de decisióncon Python, haciendo hincapié en la experiencia práctica y la claridad.
Configurando su entorno Python
1. Asegúrate de tener Python instalado en tu ordenador. Puedes descargarlo desdepython.org.
2. Instale las bibliotecas necesarias usando pip, el instalador de paquetes de Python. Abra su terminal o símbolo del sistema y ejecute:
pip install numpy pandas scikit-learn matplotlib
Estos comandos instalan NumPy y pandas para manipulación de datos, scikit-learn para aprendizaje automático y matplotlib para visualización.
Cargando y preparando su conjunto de datos
1. Importe las bibliotecas y cargue su conjunto de datos. Para este tutorial, usemos el conjunto de datos Iris, un conjunto de datos simple pero revelador disponible directamente en scikit-learn.
from sklearn.datasets import load_iris
import pandas as pd

iris = load_iris()
data = pd.DataFrame(data=iris.data, columns=iris.feature_names)
data['target'] = iris.target
2. Limpie su conjunto de datos buscando y manejando valores faltantes o valores atípicos. El conjunto de datos de Iris ya está limpio, por lo que no es necesario realizar ninguna otra acción.
3. Divida su conjunto de datos en conjuntos de entrenamiento y prueba para evaluar con precisión el rendimiento de su modelo.
from sklearn.model_selection import train_test_split

X = data.drop('target', axis=1)
y = data['target']
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
Implementación de un modelo de árbol de decisión con Scikit-learn
1. Importe DecisionTreeClassifier de scikit-learn y cree una instancia del clasificador.
from sklearn.tree import DecisionTreeClassifier

dtree = DecisionTreeClassifier(random_state=42)
2. Ajusta el modelo a tus datos de entrenamiento.
dtree.fit(X_train, y_train)
Visualizando el árbol de decisiones
1. Visualiza elÁrbol de decisiónentrenado para comprender cómo toma decisiones.
from sklearn.tree import plot_tree
import matplotlib.pyplot as plt

plt.figure(figsize=(20,10))
plot_tree(dtree, filled=True, feature_names=iris.feature_names, class_names=iris.target_names)
plt.show()
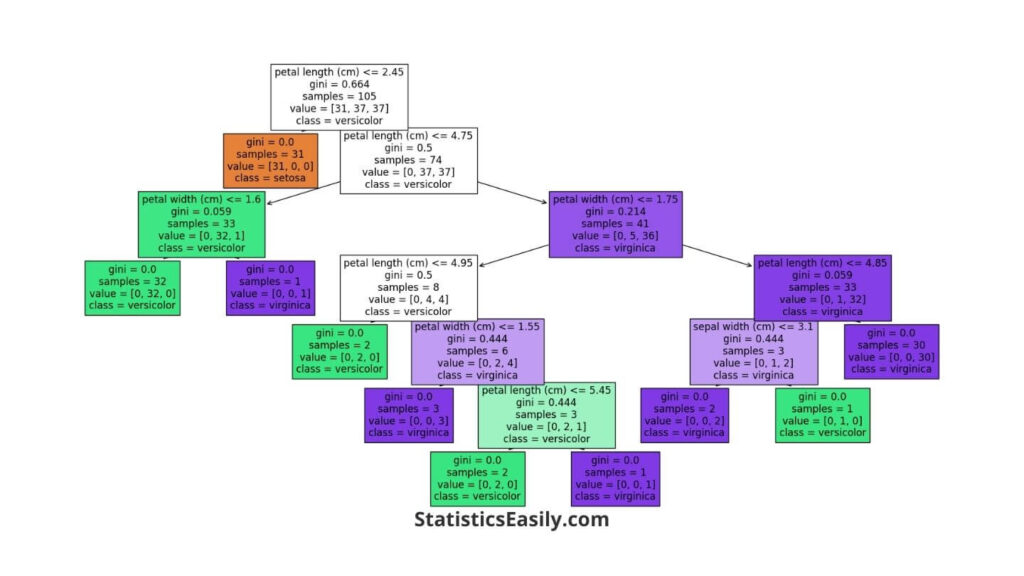
Esta imagen representa un modelo de árbol de decisión entrenado para clasificar las flores de iris en una de tres especies. Se basa en el conjunto de datos de Iris, que incluye medidas como el largo y el ancho de los pétalos. Aquí hay un desglose de lo que vemos en este árbol de decisión:
- Nodos (Rectángulos):Cada rectángulo es un nodo que toma una decisión. El árbol comienza con el nodo raíz en la parte superior y termina con el nodo hoja. Los nodos prueban los datos basándose en criterios específicos, como si la longitud del pétalo es menor que un valor particular.
- Ramas (Líneas que conectan nodos):Estas líneas guían el camino de una decisión a la siguiente en función de los criterios marcados por los nodos.
- Nodos de hoja (rectángulos finales):Los nodos finales (hojas) nos dan la clase predicha (tipo de flor de iris). No se dividen más porque representan la predicción más informada que el modelo puede hacer con los datos proporcionados.
- Gini (Métrica en nodos):La puntuación de Gini mide la pureza: 0 es completamente pura (todas las muestras de un nodo pertenecen a la misma clase) y las puntuaciones más altas indican una combinación de clases dentro de un nodo.
- Muestras (en nodos):Esto nos indica cuántos ejemplos de los datos se están considerando en este punto del árbol.
- Valor (En nodos):Esta matriz muestra la distribución de clases en las muestras en ese nodo. Por ejemplo, [0, 34, 2] significa 0 setosas, 34 versicolores y 2 virginicas.
- Clase (En nodos):Esta es la predicción del modelo en ese nodo. El árbol de decisión etiquetará cualquier punto de datos en ese nodo con esta clase.
Al observar este árbol de decisiones, podemos rastrear el camino de la toma de decisiones de arriba a abajo. Por ejemplo, supongamos que tenemos una flor de iris con una longitud de pétalo inferior a 2.45 cm. En ese caso, el Árbol de Decisión lo clasificará como setosa (como se ve en el nodo de hoja más a la izquierda). El árbol proporciona una forma transparente de ver exactamente cómo el modelo llega a una conclusión en función de las características de entrada.
Ejemplo practico
El uso del conjunto de datos Iris permite explorar los matices deÁrboles de decisiónsin verse abrumado por datos complejos. Gracias a su simplicidad y aplicabilidad en el mundo real, este conjunto de datos garantiza claridad y participación, ayudándote a comprender los fundamentos deÁrboles de decisiónen Python.
Siguiendo estos pasos, has creado y visualizado tu primerÁrbol de decisiónsiguiendo estos pasos. Este proceso — desde configurar su entorno hasta analizar un conjunto de datos simple — muestra el poder y la accesibilidad del aprendizaje automático en Python.Árboles de decisiónofrecen un método robusto e interpretable para científicos de datos de cualquier nivel, ya sea para análisis predictivos, exploración de datos o para obtener información valiosa de conjuntos de datos complejos.
Evaluación y optimización de su modelo de árboles de decisión
Después de construir su modelo de árbol de decisión en Python, los siguientes pasos críticos son la evaluación y la optimización. Estos procesos garantizan que su modelo funcione de manera efectiva y realice predicciones precisas.
Evaluación de su modelo de árbol de decisiones
El rendimiento de su modelo de árbol de decisión se puede evaluar mediante métricas como exactitud, precisión y recuperación. La precisión mide la proporción de predicciones correctas, la precisión refleja la capacidad del modelo para identificar solo instancias relevantes y la recuperación indica la capacidad del modelo para encontrar todos los casos pertinentes dentro del conjunto de datos.
from sklearn.metrics import accuracy_score, precision_score, recall_score

predictions = dtree.predict(X_test)
print(f"Accuracy: {accuracy_score(y_test, predictions)}")
print(f"Precision: {precision_score(y_test, predictions, average='macro')}")
print(f"Recall: {recall_score(y_test, predictions, average='macro')}")
Técnicas para optimizar árboles de decisión
Optimizar su árbol de decisiones implica ajustar parámetros para mejorar el rendimiento y evitar el sobreajuste. Las técnicas clave incluyen:
Poda: Consiste en reducir el tamaño del árbol para eliminar secciones con poca capacidad de clasificación de instancias. La poda se puede lograr configurando parámetros como max_depth, que limita la profundidad del árbol, y min_samples_split, que especifica el número mínimo de muestras necesarias para dividir un nodo interno.
dtree_optimized = DecisionTreeClassifier(max_depth=3, min_samples_split=5, random_state=42)
dtree_optimized.fit(X_train, y_train)
Profundidad máxima: Limitar la profundidad del árbol ayuda a evitar que el modelo se vuelva demasiado complejo y se sobreajuste a los datos de entrenamiento.
División de muestras mínimas: establecer un número mínimo de muestras para dividir un nodo ayuda a que el modelo sea más general y menos propenso a ajustarse al ruido en el conjunto de entrenamiento.
Consideraciones éticas en la optimización del modelo
Optimizar un modelo va más allá de meros ajustes técnicos; Implica consideraciones éticas, especialmente garantizar que las predicciones del modelo sean justas y no perpetúen los sesgos. El sobreajuste afecta la precisión del modelo en datos invisibles. Puede llevar a decisiones que podrían no reflejar la verdadera naturaleza de los datos o la realidad. Es crucial equilibrar la complejidad del modelo con su interpretabilidad y equidad, asegurando que las decisiones tomadas por el modelo sean justificables y éticas.
Garantizar que los modelos reflejen con precisión la realidad subraya nuestro compromiso con la verdad. Implica pruebas rigurosas en diversos conjuntos de datos para detectar y mitigar sesgos. Los científicos de datos tienen la responsabilidad ética de garantizar que sus modelos sirvan para el bien, evitando el daño que pueda surgir de predicciones inexactas.
Título del anuncio
Descripción del anuncio. Lorem ipsum dolor sit amet, consectetur adipiscing elit.
Conclusión
El recorrido por las complejidades deÁrboles de decisión‘las complejidades ha revelado la profunda capacidad de estos modelos para hacer que la ciencia de datos sea tanto accesible como impactante. A través de una mezcla de simplicidad y profundidad,Árboles de decisiónofrecen una perspectiva para visualizar conjuntos de datos complejos, facilitando la toma de decisiones informadas. Esta exploración, desde los conceptos teóricos hasta la aplicación práctica en Python, destaca la versatilidad y el poder deÁrboles de decisión. Es un testimonio de la belleza de la ciencia de datos en sí misma.
Artículos recomendados
Descubra más técnicas y conocimientos de vanguardia en ciencia de datos en nuestro blog. Profundice en los árboles de decisión y más allá para obtener una comprensión integral y una aplicación práctica en sus proyectos. ¡Explora ahora!
- Estadística descriptiva y estadística inferencial: simplificación del análisis de datos
- Modelos lineales generalizados en Python: una guía completa
- Regresión lineal con Scikit-Learn: una guía completa
- P-hacking: una amenaza oculta al análisis de datos confiable
- Regresión logística utilizando Scikit-Learn (Historia)
- Las 5 mejores herramientas gratuitas para análisis de datos en 2024
Preguntas Frecuentes (FAQ)
P1: ¿Qué son los árboles de decisión?Los árboles de decisión son modelos predictivos no lineales que se utilizan para tareas de clasificación y regresión en la ciencia de datos.
P2: ¿Por qué son importantes los árboles de decisión en el análisis de datos?Ofrecen información intuitiva y clara sobre conjuntos de datos complejos, lo que los hace esenciales para procesos de toma de decisiones informados.
P3: ¿Cómo funcionan los árboles de decisión en Python?Las bibliotecas de Python, como scikit-learn, permiten una fácil implementación y visualización de los árboles de decisión.
P4: ¿Se pueden usar los árboles de decisión tanto para clasificación como para regresión?Sí, los árboles de decisión pueden manejar ambos tipos de tareas de manera eficiente, lo que los convierte en herramientas versátiles en la ciencia de datos.
P5: ¿Qué hace que los árboles de decisión sean tan valiosos?Su simplicidad e interpretabilidad, sin sacrificar la precisión, los convierten en una herramienta invaluable para analistas y científicos.
P6: ¿Cómo evalúo el rendimiento de un árbol de decisión?Utilizando métricas como exactitud, precisión y exhaustividad, junto con inspecciones visuales del propio árbol.
P7: ¿Cuáles son los principales desafíos de los árboles de decisión?El sobreajuste puede ser un problema, lo que requiere técnicas como la poda para gestionar la complejidad del árbol.
P8: ¿Cómo manejan los árboles de decisión los datos categóricos y numéricos?Pueden manejar ambos tipos de forma inherente, dividiendo los nodos según el tipo de dato para optimizar las decisiones.
P9: ¿Qué es la poda en los árboles de decisión?La poda reduce el tamaño de los árboles de decisión eliminando secciones del árbol que ofrecen poca capacidad para clasificar instancias.
P10: ¿Cómo se pueden visualizar los árboles de decisión en Python?Utilizando bibliotecas como matplotlib y Graphviz, los árboles de decisión se pueden representar visualmente para una interpretación más sencilla.