


La ventaja de SQL para consultas de datos
Esta guía muestra a los analistas de datos y científicos cómo los principios básicos de SQL pueden crear canales de datos más rápidos, más robustos y más fáciles de mantener que los scripts de Python de propósito general.
Introducción: El costo oculto de “simplemente recorrerlo”
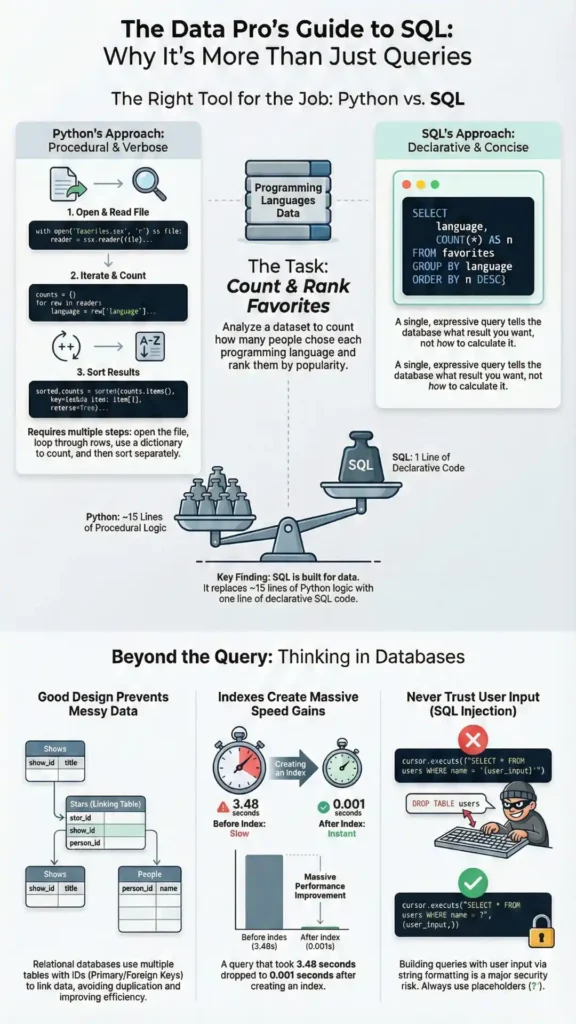
Para muchos profesionales de datos, el enfoque predeterminado para un nuevo archivo CSV es escribir un script en Python. Abrimos el archivo, recorremos las filas y creamos manualmente contadores o listas para responder preguntas aparentemente sencillas. Si bien esto funciona, a menudo resulta en un código lento y frágil, difícil de mantener. Unas pocas columnas reordenadas en el archivo fuente pueden romper todo el script. Responder a una pregunta ligeramente diferente implica reescribir bucles y condicionales complejos. Este enfoque imperativo, paso a paso, esconde una forma más potente, elegante y eficiente de trabajar con datos. Al adoptar un lenguaje especializado, podemos expresar preguntas complejas con mayor facilidad y reemplazar 17 líneas de Python frágil con una sola línea de SQL declarativo.
Conclusión 1: Haga que su ingesta de datos sea robusta
Una de las vulnerabilidades más comunes en un script de datos de Python simple es acceder a las columnas CSV por su índice numérico, como row[1]. This code is fragile because it makes a hard-coded assumption about the data’s structure. If a colleague opens the source spreadsheet and moves the second column to the third position, the script will either crash or, worse, silently produce incorrect results by processing the wrong data.
Una solución más robusta es utilizar la función integrada de Python. csv.DictReader. Instead of treating each row as a list of values, DictReader treats it as a dictionary where the keys are the column headers from the first row of the file. This allows you to access data by its meaningful name (e.g., row['language']), not its arbitrary position. The code will now work correctly even if the columns are reordered, as long as the header names remain the same.
Conexión con la ciencia de datos: Esta práctica hace que las canalizaciones de ingesta de datos sean mucho más resistentes a los cambios en los archivos de origen. Reduce los errores inesperados, minimiza el mantenimiento y garantiza que los resultados analíticos se basen en las columnas de datos correctas, mejorando así la fiabilidad de todo el flujo de trabajo.
Conclusión 2: El cambio de mentalidad declarativa
Una diferencia fundamental entre Python y SQL es el paradigma de programación que fomentan. Python es principalmente INDISPENSABLE—le dices a la computadora cómo Para obtener una respuesta paso a paso. Para contar los lenguajes de programación favoritos desde un CSV, el método de Python implica inicializar variables de contador, abrir un archivo, recorrer cada fila y usar if/elif statements to increment the correct counter. This process, which can take around 17 lines of code, is verbose and details a specific procedure.
SQL, por el contrario, es declarativo—declaras Lo que La respuesta deseada, y el motor de base de datos determina la forma más eficiente de obtenerla. La misma tarea de conteo en SQL requiere una sola sentencia: SELECT language, COUNT(*) FROM favorites GROUP BY language;. This query doesn’t specify loops or conditionals; it simply states the desired result: a count of entries for each language. This shift from describing a process to describing an outcome is a powerful mental leap.
Conexión con la ciencia de datos: El pensamiento declarativo permite a los analistas expresar preguntas complejas sobre datos de forma más directa y con menos margen para errores lógicos. En lugar de crear intrincados bucles procedimentales, pueden centrarse en definir los datos necesarios, lo que da como resultado consultas más claras, legibles y precisas.
“…parece que estamos dedicando muchísimo tiempo a desarrollar esto cuando sería bueno si pudiéramos simplificar este código… sería bueno poder responder eso súper rápido…” — Harvard CS50x 2025 (YouTube) — Clase: SQL
Conclusión 3: La buena forma de los datos no es accidental
La estructura de sus datos afecta drásticamente su capacidad para analizarlos correcta y eficientemente. Un error común, ilustrado con una hoja de cálculo del programa de televisión "The Office", es almacenar mal los datos relacionados. Un mal diseño implica agregar una nueva columna para cada estrella (star1, star2, etc.), which is inflexible and doesn’t scale. Another flawed approach is to have a row for each star, repeating the show’s title (“The Office”) over and over again, creating massive data redundancy.
La solución es un concepto de base de datos central llamado normalizaciónEn lugar de una tabla desordenada, se dividen los datos en tablas distintas para entidades distintas. Por ejemplo, se crea una shows table for TV shows and a people table for actors. You then create a third “join table,” stars, that links them together using their unique IDs (show_id y person_id).
Este diseño elimina la redundancia al reemplazar cadenas de texto largas y de longitud variable, como "The Office", por enteros pequeños y de tamaño fijo (por ejemplo, un ID de 32 o 64 bits). Este enfoque ahorra mucho espacio y mejora el rendimiento.
Conexión con la ciencia de datos: La normalización proporciona un modelo mental eficaz para la limpieza y estructuración de datos. Reconocer y corregir la redundancia en conjuntos de datos desorganizados (como hojas de cálculo) ayuda a prevenir errores analíticos y garantiza que las agregaciones y las uniones produzcan resultados correctos. Es un paso fundamental para preparar los datos para un análisis fiable.
Conclusión 4: La solución de una sola línea para el rendimiento
Las consultas lentas son un importante cuello de botella en el análisis de datos, especialmente en conjuntos de datos grandes con relaciones complejas. Por ejemplo, una consulta que unía tres tablas para encontrar todos los programas de televisión de Steve Carell tardó unos molestos 3.483 segundos en ejecutarse durante la clase. Este retraso se debe a que, sin guía, la base de datos realiza una búsqueda lineal: revisa cada fila de una tabla para encontrar coincidencias.
La solución es crear una INDEX on the column being searched. An index is a special data structure, much like the index at the back of a book, that allows the database to find specific rows almost instantly without scanning the entire table. By running a command like CREATE INDEX name_index ON people (name), you instruct the database to build an efficient lookup structure (typically a B-tree). In the lecture’s example, creating two indexes reduced a query for Steve Carell’s shows from 0.215 seconds to just 0.001 seconds—a massive performance gain.
La desventaja es que los índices consumen más espacio de almacenamiento y pueden ralentizar ligeramente las operaciones de escritura.INSERT, UPDATE, DELETE), as the index must also be updated. However, for read-heavy analytical workloads, the benefit to SELECT speed is almost always worth it.
Conexión con la ciencia de datos: Comprender los índices proporciona a los profesionales de datos una herramienta sencilla y eficaz para combatir los cuellos de botella en el rendimiento. Ante consultas lentas en grandes conjuntos de datos, crear un índice en las columnas filtradas suele ser el primer paso de optimización, y el más efectivo.
Conclusión 5: Deje de confiar en las aportaciones del usuario
Construir consultas insertando la entrada del usuario directamente en una cadena, por ejemplo con las f-strings de Python, crea una grave vulnerabilidad de seguridad conocida como ataque de inyección SQL. Esto ocurre cuando un usuario malintencionado proporciona una entrada que se ejecuta como parte del propio comando SQL.
El ejemplo clásico implica un formulario de inicio de sesión. Si el código construye una consulta como f"SELECT * FROM users WHERE username = '{username}'", a user could enter a username of admin' --. The single quote closes the string, and the -- starts a SQL comment, causing the rest of the original query (including the password check) to be ignored. The database is tricked into logging the user in as ‘admin’ without a valid password. This is famously alluded to in the “Little Bobby Tables” webcomic.
La solución es siempre use consultas parametrizadasEn lugar de usar cuerdas f, se utiliza un marcador de posición (como ?) in your SQL string. You then provide the user’s input as a separate argument. The database library ensures that the input is treated strictly as data and never as executable code, completely preventing SQL injection attacks.
Conexión con la ciencia de datos: Esta es una práctica de seguridad fundamental para quienes desarrollan aplicaciones de datos interactivas, paneles de control o cualquier herramienta que consulte una base de datos en función de filtros o datos proporcionados por el usuario. No parametrizar las consultas expone sus datos y sistemas a un riesgo significativo.
Qué aplicar hoy
- Al leer un CSV en Python, utilice
csv.DictReaderinstead of accessing columns by number. - Antes de escribir un bucle de Python para agregar datos, pregúntese: "¿Podría ser este un solo bucle?"
GROUP BYquery in SQL?” - Si ve el mismo valor de texto repetido muchas veces en una hoja de cálculo, considere dividir los datos en dos tablas vinculadas por una identificación única.
- Si
SELECTquery with aWHEREclause is slow, create anINDEXon the column(s) in theWHEREclause. - Nunca utilice cadenas f ni concatenación de cadenas para añadir la entrada del usuario a una consulta SQL. Utilice siempre marcadores de posición.
Cierre
Si bien es fácil recurrir a un lenguaje de propósito general como Python para cualquier tarea, esta lección de CS50 demuestra que los conceptos fundamentales de la informática ofrecen ventajas prácticas y poderosas para el trabajo con datos. Esta lección es solo una parte de una serie completa que demuestra cómo los temas fundamentales de la informática mejoran directamente la calidad y la eficiencia del análisis de datos. Al adoptar la naturaleza declarativa de SQL, los sólidos principios de modelado de datos y las características de rendimiento, los profesionales de datos pueden escribir código no solo más rápido, sino también más robusto y fácil de entender.
¿Qué tarea rutinaria de manejo de datos realizas en Python que podría resolverse con una sola consulta SQL declarativa ? consulta en su lugar?





