


Lo que los científicos de datos olvidan sobre la memoria
Una guía para que los analistas y científicos de datos escriban código más sólido, eficiente y predecible al comprender cómo funciona realmente la memoria.
Introducción: Los errores que no están en tu lógica
Tiene Python Script que se ejecuta perfectamente en una pequeña muestra de datos pero se bloquea con un código críptico. MemoryError on the full dataset. Or maybe you’ve encountered a bug in a data pipeline that vanishes when you try to debug it step-by-step. These frustrating problems often have nothing to do with a flaw in your business logic and everything to do with a gap in understanding what the computer is doing “under the hood.”
Muchos de estos problemas de alto nivel e impredecibles tienen su origen en conceptos fundamentales de la informática sobre la memoria. Comprenderlos no es solo un ejercicio académico; es una habilidad práctica para escribir código mejor y más fiable. Esta publicación es una síntesis basada en la conferencia CS50x 2025 (Harvard) sobre memoria, disponible en YouTube.
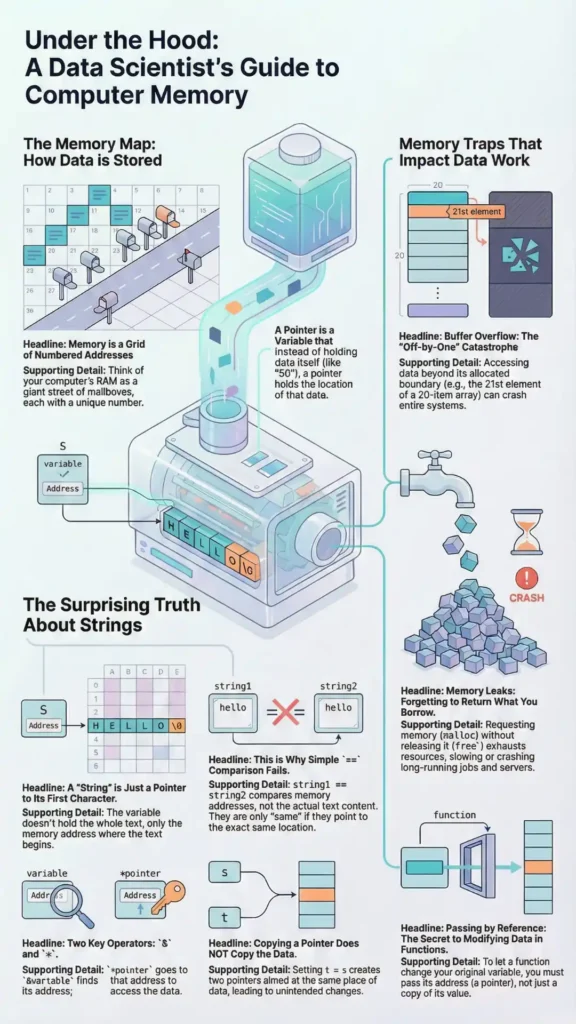
Conclusión 1: “La cuerda” es una ilusión
En muchos contextos introductorios, una string is presented as a basic data type. The CS50 library, for instance, uses it as a helpful “training wheel” to get students started. However, in a foundational language like C, there is no built-in string data type. It’s an abstraction.
Lo que llamamos una cadena es en realidad una char *—a pointer to a character. This pointer is simply the memory address of the primera Carácter en una secuencia. Para saber dónde termina la cadena, C se basa en un valor centinela especial: el terminador nulo (\0), a byte containing all zeros. Functions like printf read from the starting address character by character until they hit this null terminator. Without it, the function would just keep reading into adjacent memory, causing unpredictable behavior.
Conexión con la ciencia de datos: Este concepto es el precursor de cómo lenguajes de alto nivel como Python y R gestionan cadenas de texto y otros datos de longitud variable. Explica por qué la manipulación de cadenas puede ser computacionalmente costosa; el sistema suele buscar un punto de terminación o gestionar matrices subyacentes. Para los científicos de datos, esto es crucial al analizar archivos de texto sin formato o trabajar con API; un byte de terminación faltante o incorrecto puede provocar datos corruptos o fallos de análisis, como la lectura incorrecta de una línea de un archivo de registro, lo que trunca información de error importante.
Conclusión 2: ¿Por qué? == Can Lie About Equality
Cuando comparas dos variables enteras en C con ==, you’re comparing their values. But if you compare two string variables with ==, you are not comparing their content. Instead, you are comparing their memory direcciones.
Si tiene dos cadenas idénticas, "high" y "high", pero están almacenadas en diferentes ubicaciones en la memoria, la == operator will return false. Their content is the same, but their addresses are different. This is why C requires a special function like strcmp (string comparison), which performs a character-by-character check to determine if the strings’ values are truly identical.
Conexión con la ciencia de datos: Este es un paralelo directo al concepto de identidad de objeto versus igualdad de valores en Python. Usando is in Python compares memory addresses (identity), while == typically compares values (equality). For complex objects like Pandas DataFrames, even == can be ambiguous. This is why dedicated methods like pandas.DataFrame.equals() exist. The fundamental C behavior explains why you can’t just compare two DataFrames with a simple operator; you need a robust method that iterates through and compares their actual contents, just like strcmp does for C strings.
Conclusión 3: Una copia podría ser solo un alias
En C, una instrucción como string t = s; might look like it’s creating a new copy of string s and naming it t. It is not. This operation does not copy the string’s content (the characters ‘H’, ‘I’, ‘!’, ‘\0’). It only copies the de facturación del primer carácter de la cadena.
Esto significa ambas variables, s y t, now point to the exact same block of memory. They are two different names for the same underlying data. Consequently, if you modify the string using the variable t (for example, by capitalizing the first letter), you are also changing the string for s. There is only one string, and both variables point to it.
Conexión con la ciencia de datos: Este es el origen del problema de "vista vs. copia" que suele confundir a los usuarios de Pandas. Un científico de datos podría filtrar un DataFrame, asignarlo a una nueva variable y comenzar a realizar cambios, creyendo que está trabajando en una copia independiente. Pero si Pandas devuelve una "vista" (un alias que apunta a los datos originales), está alterando involuntariamente su conjunto de datos de origen. Esto puede provocar errores sutiles y peligrosos difíciles de rastrear, ya que los datos originales se modifican "misteriosamente" mediante una operación realizada en otro lugar.
“Cuando se usa literalmente igual a igual para comparar dos cadenas… es decir, comparar las dos estrellas de Char, es decir, comparar las dos direcciones, claramente están en diferentes lugares… necesitábamos una solución para esto y es por eso que presentamos la función stir comp que realmente abordó esto correctamente”. — Harvard CS50x 2025 (YouTube) — Clase: Memoria
Conclusión 4: La memoria es un recurso finito que debes gestionar
Cuando un programa necesita memoria mientras se ejecuta (por ejemplo, para almacenar datos leídos de un archivo), puede solicitarla al sistema operativo. En C, esto se hace con una función llamada malloc() (memory allocation), which asks for a specific number of bytes from a large memory pool called the “heap.”
Sin embargo, esta solicitud puede fallar. Si el sistema no tiene memoria disponible, malloc() will return NULL (a special pointer to address zero) to signal failure. Robust code must always check for this possibility. Furthermore, once the program is finished with that memory, it must explicitly return it to the system using free(). Failing to do so creates a “memory leak,” where the program holds onto memory it no longer needs, potentially causing it to run out of resources and crash over time.
Conexión con la ciencia de datos: Esto es directamente aplicable al trabajo con grandes conjuntos de datos. Intentar cargar un archivo CSV o Parquet masivo en un DataFrame de Pandas puede provocar fácilmente el bloqueo de un script si solicita más memoria de la que el sistema tiene disponible. Los principios de malloc y free are fundamental to writing scalable data pipelines, understanding why certain processes are “memory-bound,” and appreciating the design of modern data tools that use techniques like chunking or memory mapping to process data that won’t fit into memory all at once.
Conclusión 5: Las funciones tienen espacios de trabajo privados (The Stack)
Cuando se llama a una función, esta obtiene su propio espacio de trabajo privado en una región de memoria llamada "pila". Este "marco de pila" contiene sus variables locales, incluidos los argumentos que se le pasan.
La conferencia CS50 lo demuestra con una swap function intended to swap two integer values. The initial version fails because it only swaps copias de los valores dentro de su propio marco de pila privado. Esto se conoce como "paso por valor". Una vez que la función termina, su marco de pila desaparece y las variables originales de la función que la llama (main) are left completely unchanged. The corrected version works by “pass by reference”—passing the memory direcciones de las variables originales. Esto da la swap function the power to reach back into the caller’s stack frame and modify the original variables directly.
Conexión con la ciencia de datos: Este concepto es fundamental para comprender el alcance y la mutabilidad de las variables al escribir funciones de transformación de datos. Ayuda a explicar por qué una función podría no modificar un DataFrame como se espera (por ejemplo, si reasigna la variable internamente en lugar de modificar el objeto directamente). También subraya los principios de diseño de las "funciones puras" —funciones que no modifican sus entradas—, esenciales para crear flujos de análisis reproducibles, comprobables y sin errores.
Conclusión 6: El error de mil millones de dólares es un error de un solo dígito
Un "desbordamiento de búfer" ocurre cuando un programa intenta escribir datos más allá de los límites asignados a un búfer de memoria, como una matriz. Es como intentar verter un galón de agua en un vaso de pinta: el exceso tiene que ir a alguna parte y, a menudo, sobrescribe la memoria adyacente, causando corrupción y fallos.
La conferencia hace referencia a un incidente real relacionado con el software de seguridad CrowdStrike. Un error en una actualización provocó fallos en sistemas de todo el mundo. La causa fue sorprendentemente simple: el código esperaba una matriz con 20 valores, pero recibió 21. El intento de acceder al elemento 21 inexistente produjo una lectura de memoria fuera de límites, lo que provocó un fallo del sistema. C no ofrece protección automática contra esto, lo que lo convierte en una clara demostración de un tipo de error peligroso.
Conexión con la ciencia de datos: Esta es la lección definitiva sobre programación defensiva para el trabajo con datos. Al analizar archivos, iterar sobre listas o procesar respuestas de API, no se puede confiar en que los datos entrantes se ajusten a las expectativas. Esta vulnerabilidad de bajo nivel resalta la importancia crucial de un manejo de errores y una validación de entrada robustos. Siempre agregue comprobaciones explícitas de formatos, tamaños y límites esperados antes de procesar datos para evitar que todo el proceso falle debido a un valor inesperado.
Qué aplicar hoy: una lista de verificación práctica
- Interrogue sus controles de igualdad: Al comparar objetos complejos como modelos o DataFrames, haga una pausa y confirme si necesita saber si son los mismos. exactamente el mismo objeto en la memoria (identidad) o si simplemente contienen los mismos datos (igualdad). Utilice el método apropiado (
isfrente a.equals()) for your goal. - Audite las modificaciones de su DataFrame: Antes de modificar lo que cree que es una copia de un DataFrame, compruebe explícitamente si se trata de una vista o una copia. Un simple cambio en una vista puede dañar silenciosamente su conjunto de datos original. Use
.copy()to ensure you have an independent object. - Sea proactivo con respecto a la memoria: Al trabajar con archivos grandes, no los cargue simplemente y espere que todo salga bien. Utilice herramientas para verificar la memoria disponible del sistema y procese los archivos en fragmentos más pequeños (por ejemplo, usando
chunksizeenpandas.read_csv) to avoid requesting more memory than is available. - Validar los límites de los datos: Siempre que acceda a datos mediante un índice, como una lista o una matriz, considérelo un posible punto de fallo. Agregue comprobaciones para garantizar que el índice esté dentro del rango esperado, especialmente cuando el tamaño de los datos lo determina una fuente externa.
- Nunca confíes en los datos de entrada: Considere los datos de archivos, API o entradas de usuario como si fueran fundamentalmente poco fiables. Antes de realizar operaciones, agregue aserciones o comprobaciones explícitas de tipos, tamaños y formatos de datos para detectar problemas inesperados antes de que dañen su análisis.
9. Pensamientos finales
Estos conceptos de memoria de bajo nivel no son solo trivialidades académicas; se manifiestan directamente en los errores, cuellos de botella de rendimiento y riesgos de seguridad que encontramos en el trabajo de ciencia de datos de alto nivel. Al comprender lo que sucede en la memoria, podemos pasar de la confusión causada por los síntomas a diagnosticar la causa raíz. A medida que avanza el curso CS50, estos mismos principios se convierten en los pilares para crear las estructuras de datos eficientes que impulsan nuestras bases de datos y algoritmos.
¿Qué error "extraño" reciente en su código podría ahora explicarse por uno de estos principios básicos de memoria?





