


Lecciones de informática sobre cómo funciona realmente la IA
Para los analistas de datos y científicos, este desglose de una conferencia de informática de Harvard convierte la teoría de la informática en sabiduría práctica para su trabajo diario.
Introducción: El costo oculto de “Simplemente funciona”
¿Alguna vez has tenido dificultades para depurar el resultado extraño de un modelo o explicar una predicción de "caja negra" a una parte interesada? En ciencia de datos, solemos usar herramientas potentes que parecen "funcionar", hasta que dejan de hacerlo. La frustración por los resultados inesperados suele deberse a una brecha entre el uso de una herramienta y la comprensión de sus principios fundamentales. Al analizar los problemas de datos modernos desde la perspectiva de la informática básica, podemos pasar del simple uso de herramientas a su manejo con confianza y claridad. Esta publicación es una síntesis basada en la conferencia CS50x 2025 (Harvard) sobre Inteligencia Artificial, disponible en YouTube. La condensa en cinco conclusiones concretas que conectan la teoría de la informática con la realidad práctica del trabajo con datos, brindándote conceptos de gran utilidad que puedes aplicar de inmediato.
Conclusión 1: La IA es un espectro que abarca desde reglas simples hasta probabilidades complejas
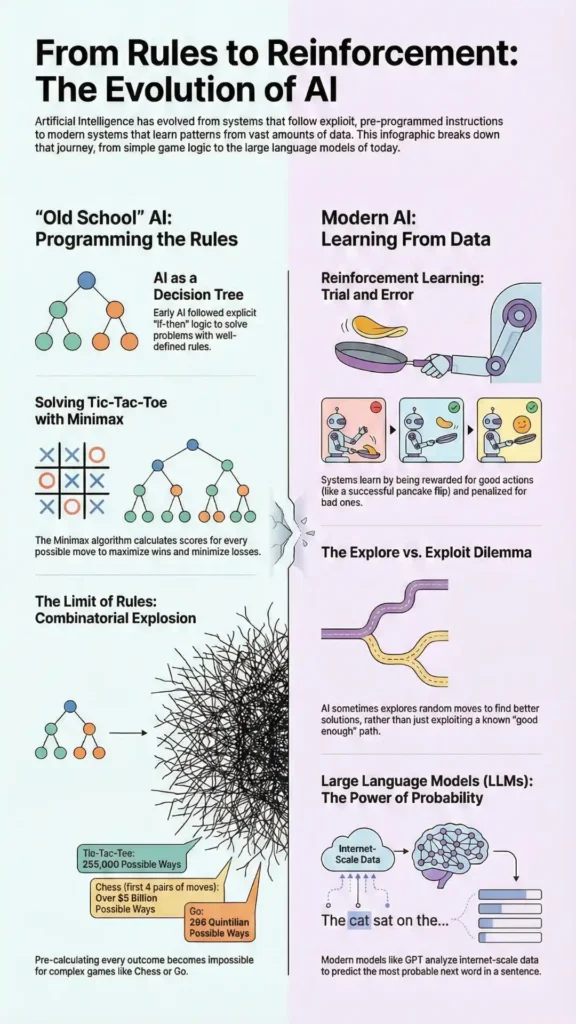
La Inteligencia Artificial no es un monolito; es un espectro. En un extremo, se encuentran los sistemas simples y deterministas. La conferencia utiliza el juego del Tres en raya como ejemplo clásico. Una IA para este juego se puede construir utilizando... árbol de decisión—una serie de if-else rules—and an algorithm called MinimaxEl algoritmo asigna una puntuación a los estados del tablero (p. ej., +1 por victoria, -1 por derrota, 0 por empate) y trabaja en sentido inverso para elegir la jugada que le permita obtener el mejor resultado posible. Este enfoque es exhaustivo y garantiza una victoria o un empate. Sin embargo, esta lógica basada en reglas solo es viable en entornos muy restringidos. Como se indica en la clase, en un juego más complejo como el ajedrez, existen más de 85 mil millones de maneras de jugar solo los primeros cuatro pares de jugadas, lo que imposibilita computacionalmente un árbol de decisión completo.
En el otro extremo del espectro se encuentran los sistemas probabilísticos modernos, como los Grandes Modelos de Lenguaje (LLM). Estos modelos no siguen reglas explícitas. En cambio, como se explica en la conferencia, funcionan prediciendo la siguiente palabra más probable en una secuencia basándose en los amplios patrones y frecuencias que aprendieron de sus datos de entrenamiento. Operan con probabilidades, no con certezas.
Conexión con la ciencia de datos: Este espectro se relaciona directamente con los enfoques comunes de la ciencia de datos. Escribir reglas de negocio explícitas en SQL, como CASE WHEN ... THEN, is like building a decision tree. In contrast, training a statistical model that assigns probabilities to different outcomes is working on the other end of the spectrum. Understanding where your specific business problem falls on this continuum—from needing deterministic rules to benefiting from probabilistic inference—is crucial for choosing the right tool for the job.
Conclusión 2: La «ingeniería de indicaciones» es simplemente un contexto estructurado
La tan aclamada habilidad de la «ingeniería de indicaciones» se centra menos en comandos esotéricos y más en proporcionar un contexto estructurado. La conferencia desmitifica este concepto utilizando como ejemplo perfecto al asistente de IA CS50, el patito de goma. Una indicación consta de dos partes clave: la indicación del sistema y el indicación del usuario. La indicación del usuario es simplemente la pregunta que formula una persona. La indicación del sistema, escrita por el desarrollador, es un conjunto de instrucciones que le indican a la IA cómo comportarse y qué restricciones debe seguir.
El equipo de CS50 le dio a su pato un mensaje de sistema muy específico para adaptar su comportamiento, desde un LLM genérico hasta un asistente de enseñanza útil, pero sin trampas. Las instrucciones incluían comandos directos como:
“Eres un asistente de enseñanza amigable y comprensivo para cs50”.
“Tú también eres un patito de goma.”
“No proporcione respuestas completas a los problemas planteados, ya que esto violaría la honestidad académica”.
Estas instrucciones proporcionan el contexto necesario para que la IA genere una respuesta útil, específica del dominio y segura, en lugar de solo la respuesta predeterminada.
Conexión con la ciencia de datos: Esto es directamente análogo a definir el alcance y las limitaciones de cualquier proyecto de análisis de datos. Una buena "guía del sistema" para un análisis no se le da a una IA, sino a usted y a sus partes interesadas. Podría incluir la definición de términos comerciales clave ("¿Qué constituye exactamente un 'usuario activo'?"), la especificación del rango de fechas o la formulación de la pregunta comercial principal que se intenta responder. Este planteamiento inicial evita esfuerzos desperdiciados, malas interpretaciones y garantiza que el análisis final sea relevante y correcto.
Conclusión 3: El equilibrio crítico: exploración vs. explotación
Uno de los conceptos más importantes en IA es el dilema entre exploración y explotación. La conferencia lo ilustra con un sencillo juego de laberinto donde un agente de IA debe encontrar una salida verde evitando pozos de lava. Inicialmente, el agente encuentra a camino correcto por casualidad y, mediante el refuerzo, aprende a seguirlo repetidamente. Esto es explotación: usar información conocida para lograr un resultado confiable.
Sin embargo, ese primer camino podría no ser el mejor . Para encontrar una ruta más óptima y corta, la IA necesita introducir una pequeña cantidad de aleatoriedad, definida en la clase como un "valor épsilon", que representa una probabilidad fija (por ejemplo, del 5 % o del 10 %) de que el agente realice un movimiento aleatorio en lugar de su mejor movimiento aprendido. Esto fomenta la exploración:probar movimientos nuevos y aleatorios, incluso si implica el riesgo de un fracaso a corto plazo, como caer en un pozo de lava. Con el tiempo, esta pequeña oportunidad de explorar permite a la IA descubrir estrategias superiores.
Este principio se demostró contundentemente en el ejemplo de una IA que aprendía a jugar al juego Breakout. Mediante pura explotación, la IA simplemente movía la raqueta de un lado a otro. Pero al explorar, descubrió la estrategia, contraintuitiva pero muy efectiva, de canalizar la pelota hacia un lado, permitiendo que el juego se desarrollara solo y acumulara una puntuación enorme.
Conexión con la ciencia de datos: Esta disyuntiva es fundamental en el trabajo de ciencia de datos. Las pruebas A/B son una versión formal de esto: se sigue utilizando la opción ganadora conocida (explotación) mientras se prueba una nueva variación para ver si es mejor (exploración). Se aplica a la optimización de modelos, donde se pueden probar nuevos hiperparámetros en lugar de mantener los que ya funcionan suficientemente bien. Incluso se aplica al desarrollo profesional: ¿se utilizan las herramientas que ya se conocen (explotación) o se dedica tiempo a aprender un nuevo lenguaje o marco de trabajo que podría ser más potente (exploración)?
Conclusión 4: Los LLM son grandes buscadores de patrones, no pensadores abstractos
Según la conferencia, los Modelos de Lenguaje Grande (MLG) no razonan ni piensan en el sentido humano. Son sistemas de coincidencia de patrones increíblemente sofisticados. Basados en redes neuronales, los LLM se entrenan previamente con grandes cantidades de texto de internet. Su función principal es calcular la siguiente palabra más probable en una secuencia, considerando las palabras anteriores.
La conferencia lo explica de forma sencilla: "...si alguien me pregunta cómo estás, probablemente basado en todos estos datos, apuesto a que el 99 % de las veces que chateo, el pato de PT o cs50 debería responder bien, gracias, ¿cómo estás?". El modelo no se siente bien; simplemente está generando la respuesta estadísticamente más probable según sus datos de entrenamiento.
Esta naturaleza probabilística es la causa directa de las alucinaciones. Cuando un modelo de lógica difusa afirma con seguridad algo que es incorrecto desde el punto de vista fáctico, es porque los patrones en sus datos de entrenamiento sugieren que la afirmación incorrecta es una secuencia de palabras que suena plausible. Está construyendo una oración estadísticamente probable, no verificando un hecho.
Conexión con la ciencia de datos: Esto tiene profundas implicaciones para los profesionales de datos. Los resultados de un modelo de lógica descriptiva (MLD) nunca deben considerarse como verdades absolutas. En cambio, deben interpretarse como hipótesis bien fundamentadas que requieren verificación con fuentes primarias. Esta mentalidad crítica es esencial para mantener el rigor analítico. Utilizar los resultados de un MLD sin validación conlleva el riesgo de propagar información errónea en informes, paneles y modelos, lo que socava la confianza depositada en su trabajo.
Conclusión 5: Una verdadera solución de IA es un sistema, no solo un modelo
Una herramienta de IA útil rara vez es un modelo independiente. Es un sistema completo construido en torno a ese modelo. La conferencia presenta un diagrama arquitectónico del depurador de patos CS50 que ilustra este punto a la perfección. El equipo de CS50 no desarrolló su propio LLM desde cero. En cambio, crearon una herramienta valiosa integrando varios componentes clave.
El sistema incluye una interfaz intuitiva para estudiantes, una base de datos local de vectores para almacenar y buscar transcripciones de las clases, y conexiones a utilizado para almacenar y buscar contenido de conferencias transcritas, y conexiones a terceros API de terceros de proveedores como OpenAI. El principal logro del equipo no radicó en crear un nuevo modelo fundamental, sino en integrar estos componentes en un sistema que resuelve eficazmente un problema educativo específico.
Conexión con la ciencia de datos: Esta es una lección crucial para los científicos de datos, que exige un cambio de mentalidad: pasar de «construyo modelos» a «diseño soluciones basadas en datos». El verdadero valor empresarial rara vez reside en un modelo aislado, por muy complejo que sea. Está en el sistema: los flujos de datos que alimentan el modelo, las API que proporcionan sus predicciones y las interfaces que lo hacen utilizable. Pensar como un arquitecto implica ampliar el enfoque, pasando de optimizar un algoritmo a diseñar un sistema completo para la resolución de problemas.
Qué aplicar hoy
- Redacte un “Indicador del sistema” para su próximo proyecto: Antes de escribir cualquier código, escribe un párrafo que defina tus objetivos, restricciones y definiciones clave, tal como lo indica el mensaje del pato CS50.
- Identificar exploración vs. explotación: En tu trabajo actual, busca un área donde estés "explotando" un proceso conocido. Pregúntate cómo sería un pequeño experimento "exploratorio".
- Mapear un problema a un árbol de decisiones: Pizarra: un problema empresarial sencillo que utiliza la
if-then-elselogic of a decision tree. Does this clarify the logic? - Verificar, no confiar: Considere la siguiente información que obtenga de una IA generativa como una hipótesis. Dedique tres minutos a verificarla con una fuente primaria.
- Piensa en sistemas: Al construir un modelo, dibuje un diagrama simple de las entradas que necesita y las salidas que producirá. ¿Cómo lo usará una persona u otro sistema?
Cierre: Del código a la cognición
Comprender los principios fundamentales de la informática que sustentan la IA no solo desmitifica la tecnología, sino que proporciona un marco para el control, la claridad y el pensamiento crítico. Conceptos como los árboles de decisión, el razonamiento probabilístico y la disyuntiva entre exploración y explotación no son teorías abstractas, sino herramientas prácticas para construir soluciones de datos más robustas y fiables. Estas ideas constituyen la base sobre la que se puede profundizar en la comprensión de temas aún más avanzados. A medida que estos sistemas probabilísticos se integren más en nuestras herramientas, ¿cómo tendremos que adaptar nuestros propios métodos para garantizar la veracidad analítica?



