


Estructuras de datos: una guía para científicos de datos
Esta publicación ayuda a los profesionales de datos a comprender las estructuras de datos fundamentales para escribir código más rápido y con mayor eficiencia en el uso de la memoria.
Un cuello de botella común en los scripts de procesamiento de datos, desde bucles de ingeniería de características lentos hasta búsquedas ineficientes, a menudo se debe a una discrepancia entre la tarea y la estructura de datos subyacente utilizada. La causa principal de estos problemas de rendimiento no suele residir en la lógica del código, sino en cómo se organizan los datos en memoria. Comprender estas estructuras (y sus desventajas) es fundamental para escribir pipelines de análisis eficientes y escalables. Esta publicación sintetizará lecciones clave sobre estructuras de datos del reconocido curso CS50x de Harvard, conectando estos fundamentos de la informática directamente con el mundo práctico del análisis y la ciencia de datos. Esta publicación es una síntesis basada en CS50x 2025 (Harvard) en YouTube.
1. Matrices y su costo oculto de cambio de tamaño
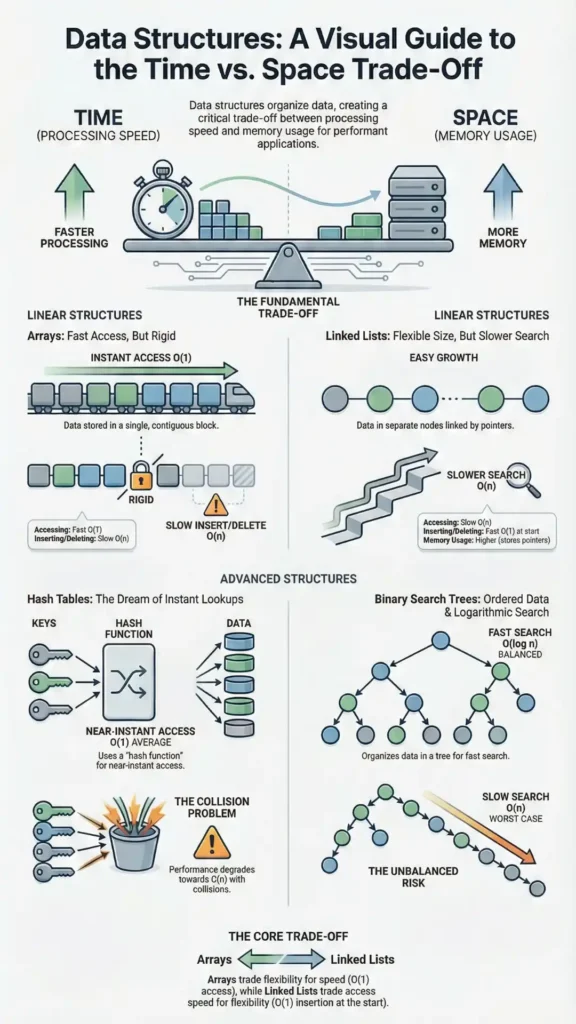
Un array es una estructura de datos simple donde los elementos del mismo tipo se almacenan uno tras otro (contiguos) en memoria. Esta disposición contigua permite acceder a cualquier elemento por su índice de forma extremadamente rápida. Sin embargo, los arrays presentan una limitación crítica: su tamaño debe determinarse con antelación.
¿Qué sucede cuando se necesita ampliar un array que ya está lleno? No se puede simplemente añadir un nuevo elemento al final si esa ubicación de memoria ya está ocupada. La única solución es asignar un bloque de memoria completamente nuevo y más grande, copiar manualmente cada elemento del array antiguo al nuevo y luego liberar la memoria utilizada por el array original. Este proceso de copia es una operación lenta y de "tiempo lineal": cuanto más grande es el array, más tarda.
Conexión con la ciencia de datos
Muchas herramientas de datos comunes, como las listas de Python, se comportan como "matrices dinámicas". Si bien parecen crecer automáticamente, realizan este costoso redimensionamiento internamente. Para agilizar las adiciones, las listas de Python utilizan la sobreasignación(reservando espacio adicional), lo que resulta en un tiempo constante amortizado (O(1)) para dichas adiciones. Sin embargo, insertar un elemento al principio de una lista grande es lento no solo por el posible redimensionamiento, sino también porque requiere desplazar cada elemento subsiguiente una posición a la derecha, un costo directo de O(n).
2. Listas enlazadas: Intercambio de memoria contigua por flexibilidad
Una lista enlazada ofrece una solución al problema de redimensionamiento rígido de las matrices. En lugar de almacenar elementos contiguos, una lista enlazada consiste en una serie de "nodos" que pueden ubicarse en cualquier lugar de la memoria. Cada nodo contiene dos elementos: un dato y un "puntero" (una dirección) que enlaza con la ubicación del siguiente nodo. Esto permite unir las ubicaciones de memoria disponibles según sea necesario.
Esta estructura introduce una compensación principal:
- Al revés: La lista puede crecer y reducirse dinámicamente sin necesidad de mover todos los elementos existentes. Esto permite un uso más eficiente de la memoria fragmentada.
- Abajo: En general, utiliza más memoria porque cada elemento requiere un puntero adicional para almacenar la dirección del siguiente.
- Desventaja crítica: Se pierde la capacidad de realizar una búsqueda binaria rápida. Dado que los elementos no se almacenan de forma contigua, no se puede acceder instantáneamente al centro de la lista; se debe recorrer nodo por nodo desde el principio.
Conexión con la ciencia de datos
Considere un registro de eventos en tiempo real donde podría ser necesario insertar o eliminar eventos en medio de una secuencia según las actualizaciones. Un Python estándar list would be punishingly slow for this, as each operation could require shifting many elements. A structure like Python’s collections.deque, however, is implemented using a doubly-linked list, providing fast O(1) appends and pops from ambas extremos.
3. La verdad contraintuitiva: la lista más rápida se construye al revés
Al trabajar con una lista enlazada, la forma en que se agregan nuevos elementos tiene un impacto significativo en el rendimiento. Para agregar un nuevo nodo al principio de la lista (incorporación), basta con crear el nuevo nodo y actualizar un par de punteros en la cabecera. Esta operación es independiente del tamaño total de la lista.
Esto hace que añadir un elemento al principio de la lista sea una operación tiempo constante (O(1)) , increíblemente rápida. En cambio, para añadir un nuevo nodo al final de la lista (añadir un elemento al final), primero hay que recorrer toda la lista desde el principio para encontrar el último nodo. Esto hace que añadir un elemento al final de la lista sea una operación de tiempo lineal (O(n)) , que se vuelve progresivamente más lenta a medida que la lista crece.
El resultado sorprendente es que la forma más eficiente de construir una lista enlazada desde cero es añadir cada nuevo elemento al principio. Esto significa que si se insertan los números 1, 2 y 3, la lista final en memoria se leerá 3 -> 2 -> 1.
Conexión con la ciencia de datos
Este es un ejemplo clásico de cómo una decisión aparentemente sencilla —añadir al frente en lugar de al final— puede tener consecuencias importantes en el rendimiento (O(1) vs. O(n)). Esto resalta la importancia de comprender la complejidad temporal de las operaciones que utilizamos a diario en scripts de limpieza de datos e ingeniería de características. Un bucle lento podría ocultar una operación lineal que podría optimizarse.
4. Árboles de búsqueda binaria: búsquedas rápidas que pueden degenerar
Un árbol binario de búsqueda (BST) intenta combinar lo mejor de ambos mundos: la rápida capacidad de búsqueda de una matriz ordenada y el redimensionamiento dinámico de una lista enlazada. Es un árbol de nodos donde cada nodo tiene hasta dos hijos. La estructura se rige por la "propiedad de búsqueda binaria": para cualquier nodo, todos los valores de su subárbol izquierdo son menores y todos los valores de su subárbol derecho son mayores.
Esta propiedad permite realizar una búsqueda binaria simplemente siguiendo los punteros izquierdo o derecho a lo largo del árbol, logrando un rendimiento de búsqueda eficiente en tiempo logarítmico (O(log n)) en promedio. Sin embargo, el árbol de búsqueda binaria (BST) tiene un defecto crítico. En el caso excepcional de insertar datos que ya están ordenados (por ejemplo, insertar 1, luego 2, luego 3 y luego 4), el árbol se desequilibra por completo. Cada nuevo nodo se añade simplemente a la derecha del anterior.
En este peor escenario, el árbol de búsqueda binaria “se convierte en una lista enlazada”. Su rendimiento de búsqueda se degrada de un tiempo logarítmico a tiempo lineal (O(n)).
Conexión con la ciencia de datos
El BST desequilibrado es una metáfora poderosa que representa la diferencia entre el rendimiento promedio y el peor de los casos. En ciencia de datos, la distribución y el orden de los datos de entrada pueden afectar drásticamente la eficiencia de un algoritmo. Por ello, los índices de bases de datos, que a menudo se basan en estructuras de árbol, requieren complejos algoritmos de equilibrio para reorganizarse continuamente y evitar que se produzca este escenario desfavorable.
5. Tablas hash: el camino práctico hacia el tiempo constante
La tabla hash es la estructura de datos predilecta para implementar diccionarios, que almacenan pares clave-valor. Combina con maestría matrices y listas enlazadas para lograr búsquedas casi instantáneas. Sus componentes principales son:
- An matriz de “cubos”.
- A función hash que toma una clave (por ejemplo, el nombre de una persona) y la convierte de manera determinista en un índice para la matriz.
- Listas enlazadas dentro de cada depósito para manejar “colisiones” (los casos en los que dos claves diferentes se convierten en el mismo índice de matriz).
La analogía de la clase sobre los estantes de recogida de Sweetgreen ilustra perfectamente esto. Tu nombre en el pedido es la clave. El empleado que mira la primera letra de tu nombre para elegir un estante (AE, FJ, etc.) es la función hash. El estante en sí es el cubo (un índice en el arreglo). Las pocas ensaladas en ese estante que tienes que revisar representan la lista enlazada para manejar colisiones. Si bien el peor caso teórico es tiempo lineal (O(n)) si todas las claves colisionan en una larga lista enlazada, el rendimiento práctico, en el caso promedio, es notablemente cercano al tiempo constante (O(1)).
Sí, las tablas hash técnicamente se basan en N dividido por K, que en realidad es simplemente el Big O de n, pero en la práctica, si eres inteligente y si eres astuto con la función hash que usas… la probabilidad de colisiones probablemente será tan baja que, incluso si ocasionalmente la cosa evoluciona a un tiempo lineal, la mayoría de las veces será, de hecho, tiempo constante, es decir, el Big O de uno. — Harvard CS50x 2025 (YouTube) — Clase: Estructuras de datos
Conexión con la ciencia de datos
Las tablas hash son el motor detrás de los diccionarios de Python (dict) and sets (set). This is why key lookups (my_dict['key']) and membership testing (item in my_set) are exceptionally fast. These structures are fundamental tools for performant data manipulation, creating lookup tables, aggregating data by category, and building features efficiently.
Qué aplicar hoy
- Siempre prefiera un diccionario/mapa hash para búsquedas de clave-valor Sobre la búsqueda en una lista de pares. La diferencia de rendimiento entre O(1) y O(n) es enorme en conjuntos de datos grandes.
- Tenga en cuenta el orden de los datos cuando el rendimiento es importante. Como se ve con los árboles de búsqueda binaria, insertar datos ordenados en ciertas estructuras puede desencadenar el peor comportamiento posible.
- Pregunta si tus datos necesitan ser ordenados. Si solo necesita búsquedas rápidas y pruebas de membresía, un conjunto (basado en hash) es mucho más eficiente que una lista.
- Visualice las operaciones subyacentes. Cuando un script es lento, piense si está forzando una operación lineal O(n) dentro de un bucle, creando inadvertidamente una complejidad O(n²).
- Reconocer el equilibrio entre tiempo y espacio. Una tabla hash (como una de Python)
dict) consumes more memory than a list to store its hash values and pointers, but it buys you dramatically faster lookups—a trade-off that is essential to writing performant code.
Cierre
El tema central es que cada estructura de datos representa un equilibrio entre tiempo, espacio y complejidad de implementación. No existe una única estructura "mejor", solo la más adecuada para la tarea en cuestión. La lección pasa a Python, un lenguaje que abstrae muchos de los detalles de la gestión manual de memoria que hemos discutido. Sin embargo, los principios de rendimiento siguen siendo igual de críticos, ya que estas estructuras siguen funcionando internamente. ¿Qué estructura de datos que usas a diario cambiarás ahora?


